

「AXプロジェクト実践ガイド」は、企業におけるAI導入のための体系的な方法論を提供する全5回のシリーズです。本シリーズは、戦略的計画(第1回)から始まり、開発手法(第2回)、重要なツールとマルチクラウドプラットフォーム(第3回)の選択、セキュリティガードレールの設計(第4回)、そして包括的なセキュリティ、ガバナンス、運用(第5回)に焦点を当てるまで、ライフサイクル全体をカバーします。
AXプロジェクト実践ガイド 連載目次
- AXプロジェクト実践ガイド 第1回 — 戦略的なAIユースケースの選定と要件定義
- AXプロジェクト実践ガイド 第2回 — 既存システム向けオープンソースAI統合パターン
- AXプロジェクト実践ガイド 第3回 — AIエージェントの安全な接続:MCPツール設計、OAuth、防御策のプレイブック
- AXプロジェクト実践ガイド 第4回 — LLMガードレール:セキュアなAI導入のための必須設計とレッドチームテスト (この記事)
- AXプロジェクト実践ガイド 第5回 — AIセキュリティガバナンスの要:LLMOps、脅威モデリング、本番稼働のための規制遵守
この第4回、「AXプロジェクト実践ガイド 第4回 — LLMガードレール:セキュアなAI導入のための必須設計とレッドチームテスト」では、AI/MLシステムインテグレーション(SI)プロジェクトの極めて重要なセキュリティ設計およびテストフェーズに焦点を当てます。このフェーズの主要な成果物には、LLMアプリケーションの詳細なセキュリティ設計書、包括的なガードレールポリシーフレームワーク、および実用的なレポートを含む堅牢なレッドチームテスト計画が含まれます。ガードレールの効果的な実装は、大規模言語モデルに関連する固有のリスクを軽減し、機密データを保護し、企業環境内での運用整合性を維持するために極めて重要です。
多層的なLLMガードレール設計
包括的なLLMセキュリティ戦略では、LLMインタラクションライフサイクルの各段階で潜在的な脆弱性に対処する多層的なガードレール設計を採用します。これには、入力処理、プロンプト実行、ツール使用、出力生成が含まれます。各層は、悪意のある活動を防止し、確立されたセキュリティポリシーへの準拠を確保する多層防御アプローチに貢献します。
入力検証とサニタイズ
LLMとの最初のインタラクションポイントであるユーザー入力は、重要な攻撃ベクトルを表します。この層のガードレールは、悪意のあるコンテンツや機密性の高いコンテンツがコアLLMに到達する前に特定し、無効化することに焦点を当てます。手法には、PII(個人を特定できる情報)およびシークレットのマスキング、禁止トピックのコンテンツフィルタリング、既知の攻撃パターンに対する検証が含まれます。
機密データ保護のため、Presidioのようなオープンソースライブラリは、PIIおよびシークレットの検出と匿名化のための堅牢な機能を提供します。組織は、韓国の住民登録番号や日本のマイナンバー識別子など、地域固有の機密データに特化したカスタム認識エンジンでこれらの機能を拡張できます。
from presidio_analyzer import AnalyzerEngine
from presidio_anonymizer import AnonymizerEngine
analyzer = AnalyzerEngine()
anonymizer = AnonymizerEngine()
text = "Please process order for John Doe, phone +82-10-1234-5678."
results = analyzer.analyze(text=text, language='en')
anonymized_text = anonymizer.anonymize(text=text, analyzer_results=results)
# Custom recognizers for region-specific data can be added.
# Example: analyzer.add_recognizer(CustomKoreanResidentNumberRecognizer())
組織は、生産システムに統合する前に、オープンソースプロジェクトのライセンス条項を確認する必要があります。
プロンプト攻撃の軽減
ダイレクトおよびインダイレクトプロンプトインジェクション、およびジェイルブレイクを含むプロンプト攻撃は、LLMの動作を操作したり、不正な情報を抽出したりする試みです。この層のガードレールは、これらの悪意のあるプロンプトがモデルの応答やアクションに影響を与えるのを検出し、防止することに焦点を当てます。
- ダイレクトプロンプトインジェクション: ユーザーがLLMのシステムプロンプトまたは指示を直接上書きまたは操作します。
- インダイレクトプロンプトインジェクション: 悪意のある指示が取得されたデータ(RAGソースなどから)に埋め込まれ、LLMがそれを正当な入力として処理します。
- ジェイルブレイク: 安全メカニズムを回避し、制限されたコンテンツや動作を引き出すように設計された巧妙なプロンプトです。
NeMo GuardrailsやLLM Guardなどのソリューションは、ポリシー駆動型ガードレールを定義するためのフレームワークを提供します。これらにより、特定のキーワード、感情、トピックの変更、または意図を検出するルールを作成し、問題のあるプロンプトをブロック、言い換え、またはエスカレートすることができます。
# Example (conceptual) guardrail policy for prompt injection
version: 0.1
flows:
  - name: detect_and_block_injection
    steps:
      - user_intent: prompt_injection_attempt
        if:
          - check_content_safety($user_input, ['jailbreak', 'malicious_code'])
        then:
          - 'utter_deny_request'
          - 'exit'
# User intents and bot responses would be defined elsewhere.
実行環境制御
LLMが外部ツール、API、またはデータベースと連携する場合、実行環境は重要なセキュリティ上の懸念となります。ガードレールは最小特権の原則を強制し、侵害されたLLM出力による潜在的な損害を封じ込める必要があります。
- 分離: LLMインスタンスとそれに関連するツールを分離された環境(コンテナ、サーバーレス機能など)で実行し、侵害された場合の横方向の移動を制限します。
- ツール権限: LLMがアクセスできるツールと、その権限を厳密に制御します。ブロックリストよりも許可リストアプローチが推奨されます。
- レート制限: LLMリクエストおよびツール呼び出しにレート制限を実装し、悪用、サービス拒否攻撃、過剰なリソース消費を防止します。
- セキュアAPIゲートウェイ: LLMによって開始されるすべてのAPI呼び出しは、認証、認可、および入出力検証を強制するセキュアAPIゲートウェイを介して渡される必要があります。
出力検証とフィルタリング
LLMによって生成された出力は、機密情報、有害なコンテンツ、またはハルシネーションされたデータが含まれている場合、セキュリティリスクをもたらす可能性があります。この層のガードレールは、ユーザーに配信される前にLLMの応答を精査します。
- スキーマ検証: 構造化された出力の場合、事前定義されたスキーマに対して検証し、期待されるデータ型と形式への準拠を保証します。
- 機密データフィルタリング: LLMの出力にPII/シークレット検出とマスキングを再適用し、偶発的なデータ漏洩を防ぎます。
- 有害コンテンツ検出: ヘイトスピーチ、暴力、自傷行為、またはその他の禁止されたコンテンツをフィルタリングします。
- グラウンディングチェック: RAGベースのシステムの場合、LLMの出力が取得されたソースドキュメントによって事実上サポートされていることを確認し、ハルシネーションを軽減します。
信頼度に基づく人間によるレビューと監査ロギング
堅牢な自動ガードレールがあっても、特定のリスクの高いシナリオや信頼度が低い出力には、人間による介入が必要になる場合があります。HITLプロセスを実装することで、重要な決定や潜在的に問題のある出力がリリース前に人間オペレーターによってレビューされることを保証します。
包括的な監査ロギングはセキュリティにとって不可欠です。すべてのインタラクション、ガードレール検出、モデルの入出力、ツール呼び出しはログに記録される必要があります。これらのログは、フォレンジック分析、コンプライアンス監査、およびガードレールポリシーの継続的な改善のための重要な証拠を提供します。エンタープライズSIEMソリューションとの統合により、一元的な監視と脅威検出機能が促進されます。
OWASP LLM Top 10とオープンソースコントロールのマッピング
OWASP Top 10 for LLM Applications (2025)は、LLM固有のセキュリティリスクを理解し、優先順位を付けるための標準化されたフレームワークを提供します。戦略的なアプローチでは、これらの特定されたリスクを特定のオープンソースコントロールとアーキテクチャパターンにマッピングします。組織は、デプロイする前に、オープンソースソフトウェアのライセンス条項を確認する必要があります。
| OWASP LLM Top 10 (2025) リスク | 説明 | 関連するオープンソースコントロール / 戦略 |
|---|---|---|
| LLM01:2025 Prompt Injection (プロンプトインジェクション) | 意図された動作から逸脱させるために、巧妙に作成された入力によってLLMを操作すること。 | NeMo Guardrails, LLM Guard / Llama Guard, 入力サニタイズ (Presidio), コンテキストフィルタリング, HITLレビュー, garak / PyRIT / promptfoo (テスト用). |
| LLM02:2025 Sensitive Information Disclosure (機密情報漏洩) | LLMによって機密データが意図せず、または悪意を持って漏洩すること。 | PII/シークレットマスキング (Presidio), RAGコンテキストフィルタ, データ最小化, 出力検証. |
| LLM03:2025 Supply Chain (サプライチェーン) | LLMアプリケーションのサプライチェーン(モデル、ライブラリ、データソースなど)における脆弱性の悪用。 | Software Bill of Materials (SBOM), 依存関係スキャン (ModelScan / Trivy, Snyk), セキュアなイメージレジストリ, サードパーティコンポーネントの精査. |
| LLM04:2025 Data and Model Poisoning (データとモデルのポイズニング) | モデルの動作に影響を与えたり、バイアスを導入したりするために、トレーニングまたは微調整中に悪意のあるデータを混入すること。 | データガバナンス, 安全なデータパイプライン, データ整合性チェック, トレーニング前データ検証. |
| LLM05:2025 Improper Output Handling (不適切な出力処理) | LLMの出力が適切に検証またはサニタイズされず、ダウンストリームシステムに脆弱性を引き起こすこと。 | 出力スキーマ検証, APIゲートウェイ, データマスキング (Presidio), 出力安全フィルタ. |
| LLM06:2025 Excessive Agency (過度なエージェンシー) | LLMエージェントが過度に広範な権限でアクションを実行し、意図しないまたは有害な結果につながること。 | ツール許可リスト, アクション確認 (HITL), 明示的な認可, 定義されたアクションスペース, コスト制限. |
| LLM07:2025 System Prompt Leakage (システムプロンプト漏洩) | LLMの内部システムプロンプトや構成データが、悪意のあるユーザーに偶発的または意図的に漏洩すること。 | 入力サニタイズ (Presidio), コンテキストフィルタリング, システムプロンプト保護 (NeMo Guardrails / LLM Guard), HITLレビュー, garak / PyRIT (テスト用). |
| LLM08:2025 Vector and Embedding Weaknesses (ベクトルと埋め込みの脆弱性) | ベクトルデータベースや埋め込み空間における脆弱性が、情報漏洩や不正アクセスにつながること。 | ベクトルDBのアクセス制御, 埋め込みの匿名化, セキュアなデータインジェクション. |
| LLM09:2025 Misinformation (誤情報) | LLMが不正確な情報、ハルシネーション、または誤解を招くコンテンツを生成し、その信頼性が損なわれること。 | グラウンディングチェック, 信頼度スコアリング, HITLレビュー, 説明可能性 (XAI) ツール, garak / promptfoo (テスト用). |
| LLM10:2025 Unbounded Consumption (無制限の消費) | 攻撃者がLLMリソースを過剰に消費させ、サービス拒否、財務コストの増大、または不正使用につながること。 | レート制限, コスト制限, リソースクォータ, APIゲートウェイによるスロットリング. |
エージェントガードレール
ツールや環境と自律的に対話できるLLMエージェントは、特殊なガードレールを必要とする追加の複雑さをもたらします。これらの制御は、エージェントの動作が定義された境界内に留まり、組織のポリシーに沿っていることを保証します。
- アクション確認: 重要なアクションや機密性の高いアクション(データベースクエリの実行、メールの送信など)の場合、エージェントが続行する前に明示的なユーザー確認を要求します。これはエージェントの決定に対するヒューマン・イン・ザ・ループメカニズムとして機能します。
- ループおよびコスト制限: エージェントが無限ループに陥ったり、過剰な計算コストを発生させたりするのを防ぐためにガードレールを実装します。これには、ツール使用の最大イテレーションを設定したり、予算しきい値を定義したりすることが含まれます。
- ツール許可リスト: エージェントが呼び出すことができる許可されたツールとAPIのリストを厳密に定義し、強制します。これにより、エージェントが不正なシステムと対話したり、未承認の操作を実行したりするのを防ぎます。
# Conceptual Python example for agent tool allowlisting
allowed_tools = {"search_database", "send_report"}
tool_requested = "search_database" # or "delete_records"
if tool_requested in allowed_tools:
    print(f"Agent is permitted to use: {tool_requested}")
    # Logic for action confirmation, loop/cost limits would follow
else:
    print(f"Agent is NOT permitted to use: {tool_requested}")
garak, PyRIT, promptfooによるレッドチームテスト(CI回帰テストとして実行)
静的なガードレールポリシーは、進化する攻撃手法に対して不十分です。脆弱性を特定し、ガードレールの有効性を検証し、LLMアプリケーション全体のセキュリティ体制を向上させるためには、プロアクティブで継続的なレッドチームテストが不可欠です。レッドチームテストは、LLMとその周辺のセキュリティメカニズムをストレステストするために、敵対的攻撃をシミュレートすることを伴います。
オープンソースのレッドチームテストツール
いくつかのオープンソースツールは、構造化されたレッドチームテストの取り組みを容易にします。
- garak: データ漏洩、バイアス、プロンプトインジェクション、ハルシネーションなど、さまざまな弱点についてモデルをプローブするように設計されたLLM脆弱性スキャナーです。敵対的テストを自動化するための幅広い検出器とジェネレーターを提供します。
- PyRIT (Python Risk Identification Tool): 生成AIシステム向けのレッドチームテストを自動化するためのフレームワークです。セキュリティチームが敵対的コンテンツを生成し、さまざまな攻撃カテゴリにわたるLLMの応答を評価するのに役立ちます。
- promptfoo: LLMプロンプトおよびモデルのテストおよび評価ツールです。厳密にはレッドチームテストツールではありませんが、特定の攻撃パターンに対する堅牢性をテストし、時間の経過とともにモデルの動作を追跡するために、プロンプトのバリエーションをテストするように適合させることができます。
これらのツールにより、セキュリティチームは、最初のガードレール実装を迂回する可能性のある脆弱性を体系的に発見し、改善のための実用的な洞察を提供できます。
# Example garak command for prompt injection testing
# This command runs garak against an OpenAI model, using a prompt injection generator
garak --model_type openai --model_name gpt-3.5-turbo \
      --generator_name simple_prompt_injection \
      --detector_name sentiment.positive \
      --evaluators completion:match \
      --generations 10 --seed 42
これらのレッドチームテスト演習をCI/CDパイプラインに自動回帰テストとして統合することで、新しいデプロイメントやモデル更新が意図せず新しい脆弱性を導入しないように保証します。セキュリティパフォーマンスを低下させたり、既存のガードレールを迂回したりする変更は、アラートをトリガーし、デプロイメントを停止させる必要があります。
組織は、KYRA AI GuardrailのようなソリューションでAIセキュリティ体制をさらに強化できます。これは、継続的なセキュリティ検証、リアルタイムの脅威検出、およびさまざまなLLMデプロイメントにわたるポリシー強制のための高度な機能を提供し、オープンソースツールを補完します。
まとめ
堅牢なLLMガードレールの設計と実装、および継続的なレッドチームテストは、セキュアな生成AI導入の基盤です。入力、プロンプト、実行、出力の各段階に対処する多層的なアプローチは、人間による監視と包括的なロギングと組み合わせることで、強力な防御を提供します。Presidio、NeMo Guardrails、LLM Guard、garakなどのオープンソースツールを活用することで、組織はOWASP LLM Top 10などのフレームワークによって特定されたリスクを軽減する、回復力のあるAIアーキテクチャを構築できます。CI/CDパイプラインに統合された自動レッドチームテストによるプロアクティブな検証は、継続的なセキュリティと新たな脅威への適応性を保証します。
この回の成果物サンプル
以下は、オープンソースのAXラボを基にしたこのフェーズの成果物サンプルです。組織の環境に合わせて調整してご利用ください。要件定義書の全体(Excel)はAXプロジェクト実践ガイドのハブからダウンロードできます。
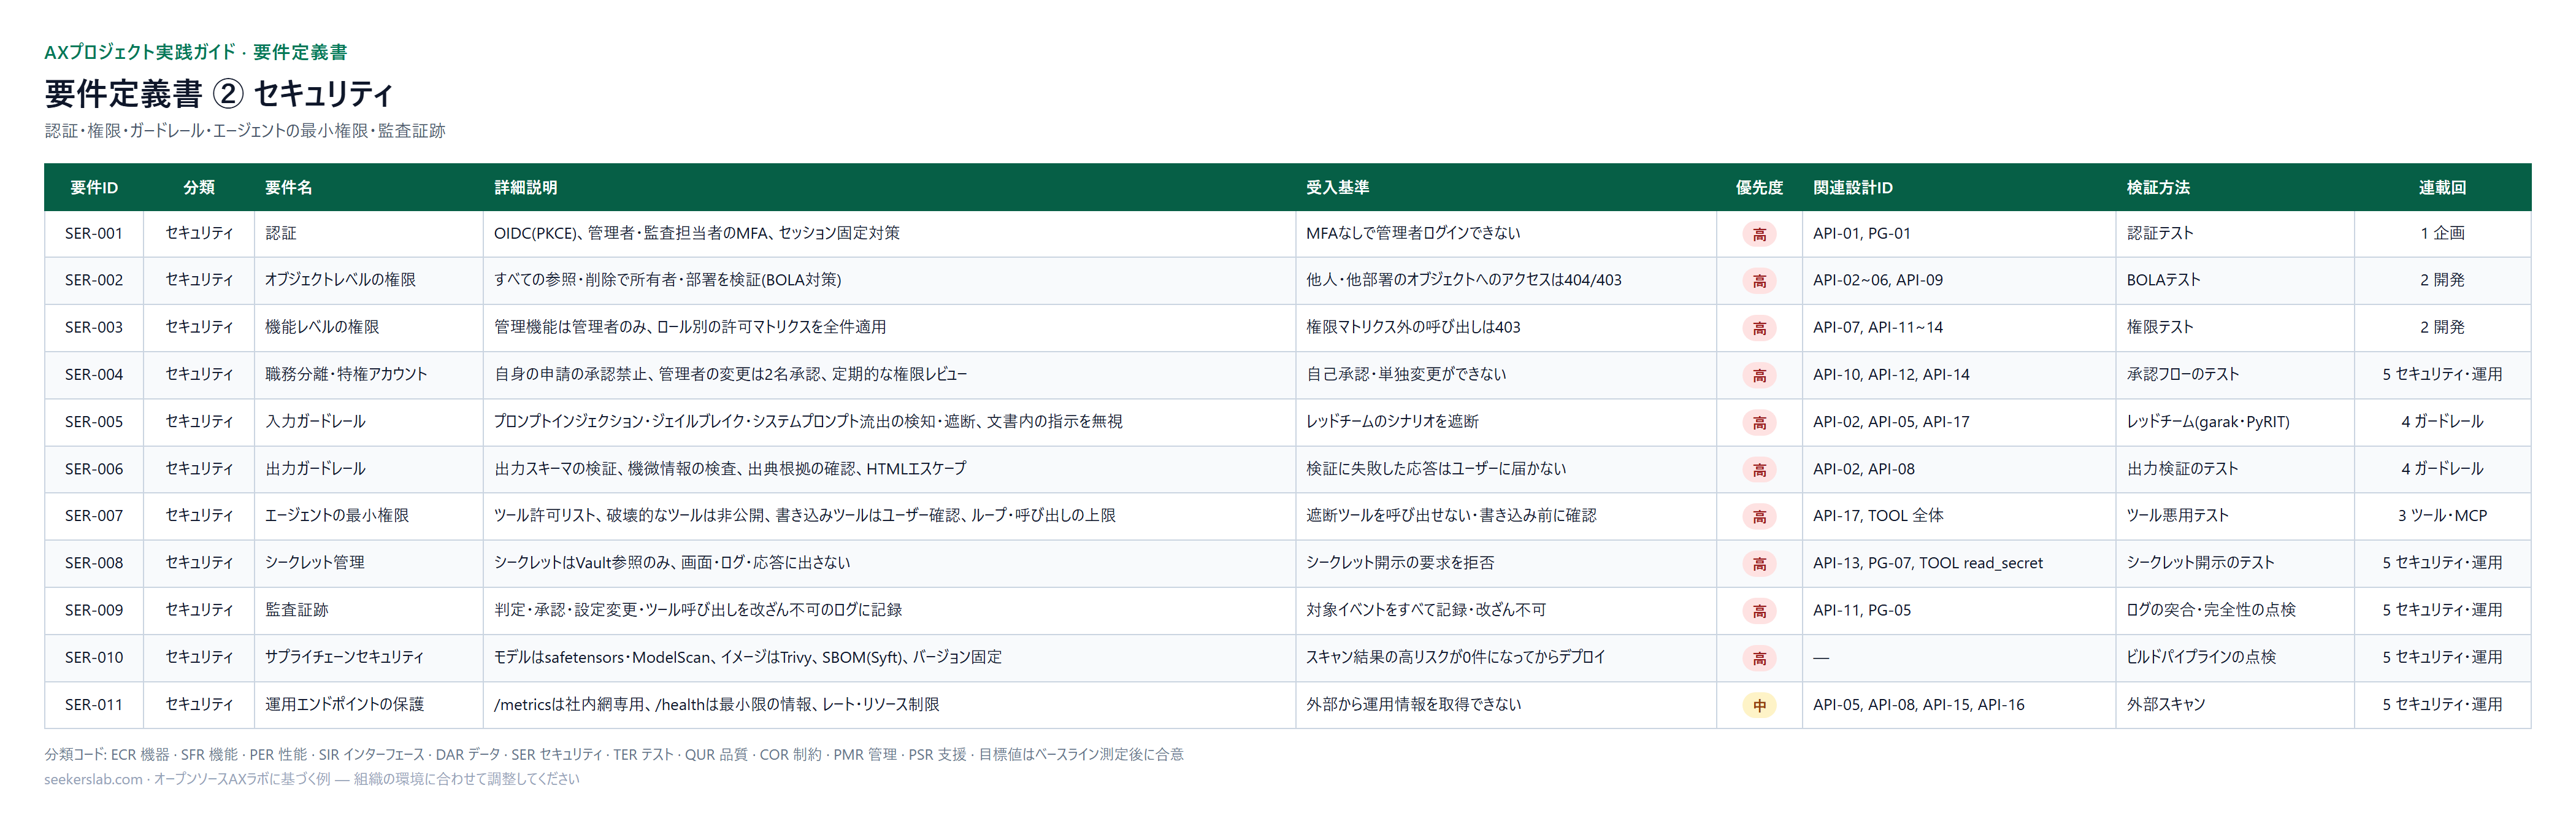 要件定義書 ② セキュリティ — 認証・権限・ガードレール・エージェントの最小権限・監査証跡
表で見る: 要件定義書 ② セキュリティ
| 要件ID | 分類 | 要件名 | 詳細説明 | 受入基準 | 優先度 | 関連設計ID | 検証方法 | 連載回 |
|---|---|---|---|---|---|---|---|---|
| SER-001 | セキュリティ | 認証 | OIDC(PKCE)、管理者・監査担当者のMFA、セッション固定対策 | MFAなしで管理者ログインできない | 高 | API-01, PG-01 | 認証テスト | 1 企画 |
| SER-002 | セキュリティ | オブジェクトレベルの権限 | すべての参照・削除で所有者・部署を検証(BOLA対策) | 他人・他部署のオブジェクトへのアクセスは404/403 | 高 | API-02~06, API-09 | BOLAテスト | 2 開発 |
| SER-003 | セキュリティ | 機能レベルの権限 | 管理機能は管理者のみ、ロール別の許可マトリクスを全件適用 | 権限マトリクス外の呼び出しは403 | 高 | API-07, API-11~14 | 権限テスト | 2 開発 |
| SER-004 | セキュリティ | 職務分離・特権アカウント | 自身の申請の承認禁止、管理者の変更は2名承認、定期的な権限レビュー | 自己承認・単独変更ができない | 高 | API-10, API-12, API-14 | 承認フローのテスト | 5 セキュリティ・運用 |
| SER-005 | セキュリティ | 入力ガードレール | プロンプトインジェクション・ジェイルブレイク・システムプロンプト流出の検知・遮断、文書内の指示を無視 | レッドチームのシナリオを遮断 | 高 | API-02, API-05, API-17 | レッドチーム(garak・PyRIT) | 4 ガードレール |
| SER-006 | セキュリティ | 出力ガードレール | 出力スキーマの検証、機微情報の検査、出典根拠の確認、HTMLエスケープ | 検証に失敗した応答はユーザーに届かない | 高 | API-02, API-08 | 出力検証のテスト | 4 ガードレール |
| SER-007 | セキュリティ | エージェントの最小権限 | ツール許可リスト、破壊的なツールは非公開、書き込みツールはユーザー確認、ループ・呼び出しの上限 | 遮断ツールを呼び出せない・書き込み前に確認 | 高 | API-17, TOOL 全体 | ツール悪用テスト | 3 ツール・MCP |
| SER-008 | セキュリティ | シークレット管理 | シークレットはVault参照のみ、画面・ログ・応答に出さない | シークレット開示の要求を拒否 | 高 | API-13, PG-07, TOOL read_secret | シークレット開示のテスト | 5 セキュリティ・運用 |
| SER-009 | セキュリティ | 監査証跡 | 判定・承認・設定変更・ツール呼び出しを改ざん不可のログに記録 | 対象イベントをすべて記録・改ざん不可 | 高 | API-11, PG-05 | ログの突合・完全性の点検 | 5 セキュリティ・運用 |
| SER-010 | セキュリティ | サプライチェーンセキュリティ | モデルはsafetensors・ModelScan、イメージはTrivy、SBOM(Syft)、バージョン固定 | スキャン結果の高リスクが0件になってからデプロイ | 高 | — | ビルドパイプラインの点検 | 5 セキュリティ・運用 |
| SER-011 | セキュリティ | 運用エンドポイントの保護 | /metricsは社内網専用、/healthは最小限の情報、レート・リソース制限 | 外部から運用情報を取得できない | 中 | API-05, API-08, API-15, API-16 | 外部スキャン | 5 セキュリティ・運用 |
よくある質問
Q1: LLMガードレールの主な目的は何ですか?
A1: LLMガードレールは、大規模言語モデルが有害、非倫理的、または安全でないコンテンツを生成したり、機密データを漏洩したり、不正なアクションを実行したりするのを防ぐために設計されたセキュリティメカニズムです。その主な目的は、企業環境内でAIアプリケーションの安全、コンプライアンスに準拠した、信頼性の高い運用を保証することです。
Q2: オープンソースツールはLLMセキュリティにどのように貢献しますか?
A2: オープンソースツールは、さまざまなLLMガードレールとセキュリティテストを実装するための費用対効果が高く、柔軟なソリューションを提供します。PresidioのようなプロジェクトはPIIマスキングを提供し、NeMo GuardrailsとLLM Guardはプロンプト攻撃の軽減に役立ち、garakは自動レッドチームテストを容易にし、組織がカスタマイズ可能で透明性の高いセキュリティ層を構築できるようにします。
Q3: ガードレールによって対処されるプロンプト攻撃の主な種類は何ですか?
A3: プロンプト攻撃の主な種類には、ユーザーがLLMの指示を直接操作するダイレクトプロンプトインジェクション、悪意のある指示が外部データに埋め込まれるインダイレクトプロンプトインジェクション、およびモデルの安全メカニズムを迂回して禁止された応答を引き出そうとする巧妙な試みであるジェイルブレイクがあります。
Q4: LLMセキュリティにおいてレッドチームテストが重要なのはなぜですか?
A4: レッドチームテストは、敵対的攻撃をシミュレートすることにより、LLMアプリケーションとそのガードレールにおける脆弱性と弱点をプロアクティブに特定するため、LLMセキュリティにとって極めて重要です。これにより、セキュリティチームは盲点を発見し、既存の制御の有効性を検証し、本番環境で悪用される前に、進化する脅威に対してセキュリティ体制を継続的に洗練させることができます。
Q5: OWASP LLM Top 10はガードレール実装とどのように関連していますか?
A5: OWASP LLM Top 10は、LLMアプリケーションに特有の最も重大なセキュリティリスクの優先順位付けられたリストを提供します。これは、セキュリティチームが脅威の状況を理解するための包括的なガイドとして機能し、特定されたこれらの脆弱性(プロンプトインジェクション、機密情報漏洩など)に直接対処するガードレールを戦略的に設計および実装するのに役立ち、集中的で効果的なセキュリティ戦略を保証します。
次回、第5回では、本パートで議論された基礎的なセキュリティアーキテクチャの上に、エンタープライズAI/MLシステムの包括的なセキュリティ、ガバナンス、および運用の重要な側面について深く掘り下げます。
← 前の記事: AXプロジェクト実践ガイド 第3回 — AIエージェントの安全な接続:MCPツール設計、OAuth、防御策のプレイブック
次の記事: AXプロジェクト実践ガイド 第5回 — AIセキュリティガバナンスの要:LLMOps、脅威モデリング、本番稼働のための規制遵守 →
AXプロジェクトのご相談
既存システムにAIを加えるAXプロジェクトを、ユースケースの選定・要件定義から構築まで、SeekersLabがSI方式でご支援します。導入をご検討中の方はお気軽にお問い合わせください。
- メール: contact@seekerslab.com
- 電話: +82-2-2039-8160(平日 09:00〜18:00、韓国時間)