

「AXプロジェクト実践ガイド」シリーズは、エンタープライズシステムへのAI機能統合に向けた構造的なアプローチを提供します。全5回(1 企画、2 開発、3 ツール・MCP、4 ガードレール、5 セキュリティ・ガバナンス・運用)で構成される本シリーズは、AI導入の複雑性を乗り越えるシステムインテグレーター(SIer)向けの包括的なフレームワークを提供します。第2回となる今回は、既存システムにオープンソースコンポーネントを用いてAIを追加する際の開発フェーズ、特に設計と構築の側面に焦点を当てます。このフェーズの主要な成果物には、詳細なアーキテクチャ設計、定義済みエンドポイント権限を含むAPI仕様書、関連権限を含むページ仕様書、最終化されたソースコード、および堅牢な評価パイプラインが含まれます。
AXプロジェクト実践ガイド 連載目次
アーキテクチャパターン比較表
既存システムへAIを効果的に統合するには、適切なアーキテクチャパターンを選択することが重要です。その選択は、タスクの複雑さ、外部データの必要性、およびモデルに求められる自律性のレベルによって異なります。以下の表は、一般的なパターンを比較したものです。
| パターン | 説明 | ユースケース例 | 利点 | 欠点 |
|---|---|---|---|---|
| Prompt-Only (Zero/Few-Shot) | LLMに最小限のコンテキストで直接プロンプトを与えます。LLMの事前学習済み知識に大きく依存します。 | シンプルなテキスト生成、短い入力の要約。 | 迅速な実装、低いオーバーヘッド。 | ハルシネーション、限定的なドメイン知識、コンテキストウィンドウの制限。 |
| Retrieval Augmented Generation (RAG) | 回答生成前にナレッジベースから関連するコンテキストを取得します。 | エンタープライズ検索、社内ドキュメントを使用する顧客サポートチャットボット。 | ハルシネーションの削減、ドメイン固有の回答、最新情報のサポート。 | 複雑さの増加、検索レイテンシ、データインデックス作成のオーバーヘッド。 |
| Tool-Using Agent | LLMが外部ツール(API、データベース)を使用して情報を収集したり、アクションを実行したりします。 | 自動データ検索、外部システムとの連携を必要とする複雑なクエリ。 | LLM固有の知識を超えた拡張可能な機能、ワークフローの自動化。 | より高い複雑さ、不正確なツール使用の可能性、セキュリティ上の影響。 |
| Rule-Engine Verdict Layer | LLMの出力が、決定論的なルールエンジン(例: Crux)によって評価または補強されます。パターンにはRULE(ルール優先)、AGENT(LLM優先)、HYBRIDがあります。 | コンプライアンスチェック、LLM出力の検証が必要な重要な意思決定支援。 | 正確性とコンプライアンスの確保、LLMリスクの軽減、監査可能な決定。 | ルールの開発およびメンテナンス作業の増加、ルール間の競合の可能性。 |
| Multi-Agent Systems | 複数のLLMベースのエージェントが連携して複雑な目標を達成します。それぞれが専門的な役割を担います。 | 自動調査、多様な視点を必要とする複雑な問題解決。 | 非常に複雑なタスクに対応、人間チームのコラボレーションを模倣。 | 著しく高い複雑さ、オーケストレーションの課題、パフォーマンスオーバーヘッド。 |
既存システムへのAI統合、特にドメイン固有の回答提供やデータ解釈支援においては、Retrieval Augmented Generation (RAG) パターンが複雑さとパフォーマンスの最適なバランスを提供します。これにより、ハルシネーションのリスクを大幅に軽減し、LLMの回答を検証可能な企業データに基づいて根拠づけることができます。以降で提示するアーキテクチャでは、主にRAGパターンを活用します。
モデル選択と提供
モデル選択
オープンソースのLLMエコシステムには、多様な選択肢があります。主な考慮事項には、モデルサイズ、パフォーマンス、ライセンス、およびコミュニティサポートが含まれます。主要な選択肢は以下の通りです。
- Mistral-7B/Mixtral-8x7B: 優れたパフォーマンス、効率性、および寛容なライセンス(Apache 2.0または特定のMistralライセンス)で知られています。
- Llama 2/3: Metaのモデルは高品質ですが、非常に大規模な企業向けに利用制限があります。Llamaモデルの具体的なライセンスは、展開前に慎重に確認することが不可欠です。
- Qwen: Alibaba Cloudのシリーズは、様々なタスクで競争力のあるパフォーマンスを提供しますが、検証が必要な独自のオープンソースライセンスを持っています。
初期開発およびテストには、Mistral-7Bのようなより小さく効率的なモデルがしばしば適しています。本番環境に展開する前に、選択したオープンソースモデルに関連する具体的なライセンスを必ず確認し、遵守することが重要です。
LLM提供
- 開発: Ollama: ローカル開発および迅速なプロトタイピングにおいて、Ollamaは様々なオープンソースモデルを民生用ハードウェアで実行するための簡単な方法を提供します。モデルのダウンロードとローカルAPIの公開を簡素化します。pgvectorについては、ベクトルストレージにおける役割としてRAGセクションで後述しますが、OllamaのようなローカルLLMと並行して初期設定を行うことは、開発環境構築の一部となることがよくあります。
# Download and install Ollama from ollama.com # Pull a model, e.g., Mistral ollama pull mistral # Run a local PostgreSQL instance with pgvector (example using Docker) docker run --name some-postgres -e POSTGRES_PASSWORD=mysecretpassword -p 5432:5432 -d pgvector/pgvector- 本番: vLLM: 本番環境での高スループット、低レイテンシの推論には、vLLMが推奨されます。これは、PagedAttentionのような技術を通じてLLMの提供を最適化し、スループットを大幅に向上させ、メモリフットプリントを削減します。vLLMのデプロイは通常、コンテナ化され、Kubernetes内のGPUアクセラレーション対応インフラストラクチャ上で実行されます。
# Example: vLLM Python serving (simplified)
from vllm import LLM, SamplingParams
llm = LLM(model="mistralai/Mistral-7B-Instruct-v0.2")
sampling_params = SamplingParams(temperature=0.7, top_p=0.9, max_tokens=256)
prompts = ["Explain the RAG architecture."]
outputs = llm.generate(prompts, sampling_params)
for output in outputs:
    prompt = output.prompt
    generated_text = output.outputs[0].text
    print(f"Prompt: {prompt!r}, Generated text: {generated_text!r}")
このコードスニペットは、通常APIを介して公開されるvLLMサーバーとのやり取りを示しています。
RAGパイプライン
LLMの回答を企業データに根拠づけるためには、堅牢なRAGパイプラインが不可欠です。主要なコンポーネントには、埋め込み、ベクトルストレージ、検索、リランキング、およびオーケストレーションが含まれます。
埋め込みとベクトルストア
- 埋め込み: BGE-M3: BGE-M3 (BAAI General Embedding)は、複数の言語とテキスト/画像混合入力を処理できる非常に効果的な埋め込みモデルです。これは、意味的類似性検索において良好なパフォーマンスを提供します。
- ベクトルストア: pgvector: pgvectorとPostgreSQLの統合により、従来のRDBデータと並行してベクトル埋め込みを直接保存およびクエリできます。これにより、既存のデータベースを活用することでインフラストラクチャが簡素化され、強力なSQLベースのフィルタリングと結合が可能になります。
検索とリランキング
- 検索: ドキュメントがチャンク化され、pgvectorに埋め込まれると、検索はベクトルストアをクエリして、ユーザーの入力クエリに最も意味的に類似したチャンクを見つけることを含みます。
- リランキング: bge-reranker: 初期検索後、bge-rerankerのようなリランカーは、検索されたドキュメントの品質を大幅に向上させることができます。これは、上位k件の検索されたドキュメントの関連性を再評価し、最も適切な情報がLLMに渡されるようにすることで、応答の精度を高め、ノイズを削減します。
LangGraphによるオーケストレーション
LangChain上に構築されたLangGraphは、LLMを用いた堅牢でステートフルなマルチアクターアプリケーションの作成を容易にします。これは、動的な検索、条件付きロジック、反復的な洗練を可能にする、複雑なRAGフローのオーケストレーションに最適です。LangGraphベースのRAGパイプラインには、以下が含まれます。
- Ingestion: ドキュメントの読み込み、チャンク化、埋め込み、pgvectorへの保存。
- Query Processing: ユーザークエリの埋め込み、pgvectorからの初期検索。
- Reranking: 検索されたドキュメントを洗練するためのbge-rerankerの適用。
- Generation: リランキングされたドキュメントと元のクエリをLLMに渡し、回答を生成。
- Conditional Logic: 関連性の確認、ツール呼び出しの必要性の判断、明確化のためのループなどのステップの実装。
# Pseudocode for a LangGraph RAG chain (simplified)
from langgraph.graph import StateGraph, START, END
# Define graph state and node functions
workflow = StateGraph(object) # Simplified state for example
workflow.add_node("retrieve", lambda state: {"documents": ["doc"]})
workflow.add_node("generate", lambda state: {"response": "answer"})
workflow.add_edge(START, "retrieve")
workflow.add_edge("retrieve", "generate")
workflow.add_edge("generate", END)
app = workflow.compile()
JSON Schema、Confidence、Rationaleを用いた構造化出力
LLMの出力を既存システムに効果的に統合するには、構造化された出力が不可欠です。これにより、ダウンストリームシステムはAIの応答をプログラムで解析、検証、実行できます。JSON schemaは、期待される出力フォーマットを定義し、データ型を強制し、一貫性を確保するための推奨される方法です。
各AIの判断にconfidenceスコアとrationaleを含めることで、透明性と信頼性が向上します。confidenceスコア(例:0.0から1.0までの浮動小数点数)はLLMの回答に対する確実性を示し、rationaleは簡単な説明または裏付けとなる証拠を提供します。この構造は、特に判断APIにとって価値があります。
{
  "$schema": "http://json-schema.org/draft-07/schema#",
  "title": "AI Verdict Output",
  "type": "object",
  "properties": {
    "verdict": {
      "type": "string",
      "enum": ["RULE", "AGENT", "HYBRID", "UNKNOWN"],
      "description": "The final verdict type."
    },
    "decision": {
      "type": "string",
      "description": "The AI's decision or answer."
    },
    "confidence": {
      "type": "number",
      "format": "float",
      "minimum": 0.0,
      "maximum": 1.0,
      "description": "Confidence score of the decision."
    },
    "rationale": {
      "type": "string",
      "description": "Explanation or evidence supporting the decision."
    },
    "source_documents": {
      "type": "array",
      "items": {
        "type": "string"
      },
      "description": "List of source documents or references used."
    }
  },
  "required": ["verdict", "decision", "confidence", "rationale"]
}
重要なアプリケーションの場合、ルールエンジン判断レイヤーはLLM出力を補強または上書きできます。これにより、決定論的なルールエンジンを統合して厳格なビジネスルールやコンプライアンスポリシーを強制し、判断をRULE(ルール駆動)、AGENT(LLM駆動)、またはHYBRID(組み合わせアプローチ)として分類できます。
人間によるレビューキュー
AIの進歩にもかかわらず、特に機密性の高い領域や影響の大きい意思決定においては、ヒューマン・イン・ザ・ループ(HITL)プロセスが依然として重要です。人間によるレビューキューは、特定の信頼度しきい値を下回るAI出力や、特定のキーワードでフラグが立てられたAI出力が手動での検査と修正のためにルーティングされるフォールバックメカニズムとして機能します。これはエラーを防ぐだけでなく、モデルのファインチューニングと評価のための貴重なフィードバックも提供します。
人間によるレビューキューの設計には、以下を含めるべきです。
- レビュー担当者がAI出力を迅速に評価し、修正を提供するためのユーザーインターフェース。
- エスカレーションと解決のための定義済みワークフロー。
- データセット改善のためにレビュー担当者のフィードバックを収集するメカニズム。
評価
AIシステムのパフォーマンスと信頼性を維持するためには、継続的な評価が不可欠です。堅牢な評価パイプラインは、CI/CDプロセスに統合され、リグレッションを検出し、品質を監視する必要があります。
- Golden Set Creation: 入力クエリとそれに対応する人間によって検証された理想的な出力からなるキュレーションされたデータセット。このセットは、AIパフォーマンスを評価するための真の基準として機能します。多様なシナリオ、エッジケース、進化するビジネスルールをカバーする必要があります。
- Ragas for RAG Evaluation: Ragasは、RAGパイプラインを評価するために特別に設計されたオープンソースフレームワークです。以下のメトリクスを測定します。
- Faithfulness: 生成された回答が、取得されたコンテキストに基づいてどれだけ事実に忠実であるかを測定します。
- Answer Relevance: 生成された回答が質問に直接対応しているかを評価します。
- Context Relevance: 取得されたコンテキストが質問に関連しているかを評価します。
- Context Recall: 回答に必要なすべての情報が取得されたコンテキストに存在するかどうかを確認します。
- Promptfoo for Regression Testing: promptfooをCIパイプラインに統合することで、LLMプロンプトと構成の自動リグレッションテストが可能になります。これにより、コード変更のたびにゴールデンセットに対して一連のテストを実行し、更新がパフォーマンスを低下させたり、新しい問題を引き起こしたりしないことを保証します。
# Example of integrating promptfoo in CI
# Assuming promptfoo is installed and a config file (promptfoocfg.yaml) exists
# This command would be part of a CI/CD pipeline script
promptfoo eval -c promptfoocfg.yaml
# Example promptfoocfg.yaml structure (simplified)
events:
  - prompt: "Explain the RAG process."
    vars:
      context: "{{ retrieve_docs(input.question) }}"
    assert:
      - type: llm-rubric
        value: "The response accurately explains RAG."
        threshold: 4 # on a scale of 1-5
APIおよびページ権限設計
既存アプリケーションにAI機能を統合するには、セキュリティを維持しアクセスを制御するために、APIエンドポイントとユーザーインターフェースの権限を慎重に設計する必要があります。最小権限の原則を遵守してください。
- API Specification: AIサービス用の新しいAPIエンドポイント(例:
/api/v1/ai/query、/api/v1/ai/verdict)を定義します。各エンドポイントは、認証メカニズム(例: OAuth 2.0、APIキー)と認可ポリシー(例: ロールベースアクセス制御 - RBAC)を指定する必要があります。AIモデルからの構造化JSON出力を含む、入力および出力スキーマを明確に文書化します。 - Endpoint Permissions: 各AI搭載APIエンドポイントにきめ細かな権限を実装します。例えば、ユーザーロールはAIへのクエリを許可されるかもしれませんが、管理者ロールは評価メトリクスや構成エンドポイントへのアクセス権を持つ場合があります。
- Page Specification with Permissions: AIサービスと連携する新しいUIコンポーネントやページ(例: チャットボットインターフェース、判断レビューキュー)については、対応するページレベルの権限を定義します。承認されたユーザーのみがAI生成コンテンツや構成を表示、操作、または変更できることを確認します。
次のステップ
AI統合の基礎的な設計と実装を基盤として、次のフェーズでは、開発ライフサイクルの最適化、適切なツールの選択、および堅牢な機械学習運用(MLOps)フレームワークの確立に焦点を当てます。これには、モデルのデプロイ、監視、反復的な改善に関する詳細な計画が含まれます。
この回の成果物サンプル
以下は、オープンソースのAXラボを基にしたこのフェーズの成果物サンプルです。組織の環境に合わせて調整してご利用ください。要件定義書の全体(Excel)はAXプロジェクト実践ガイドのハブからダウンロードできます。
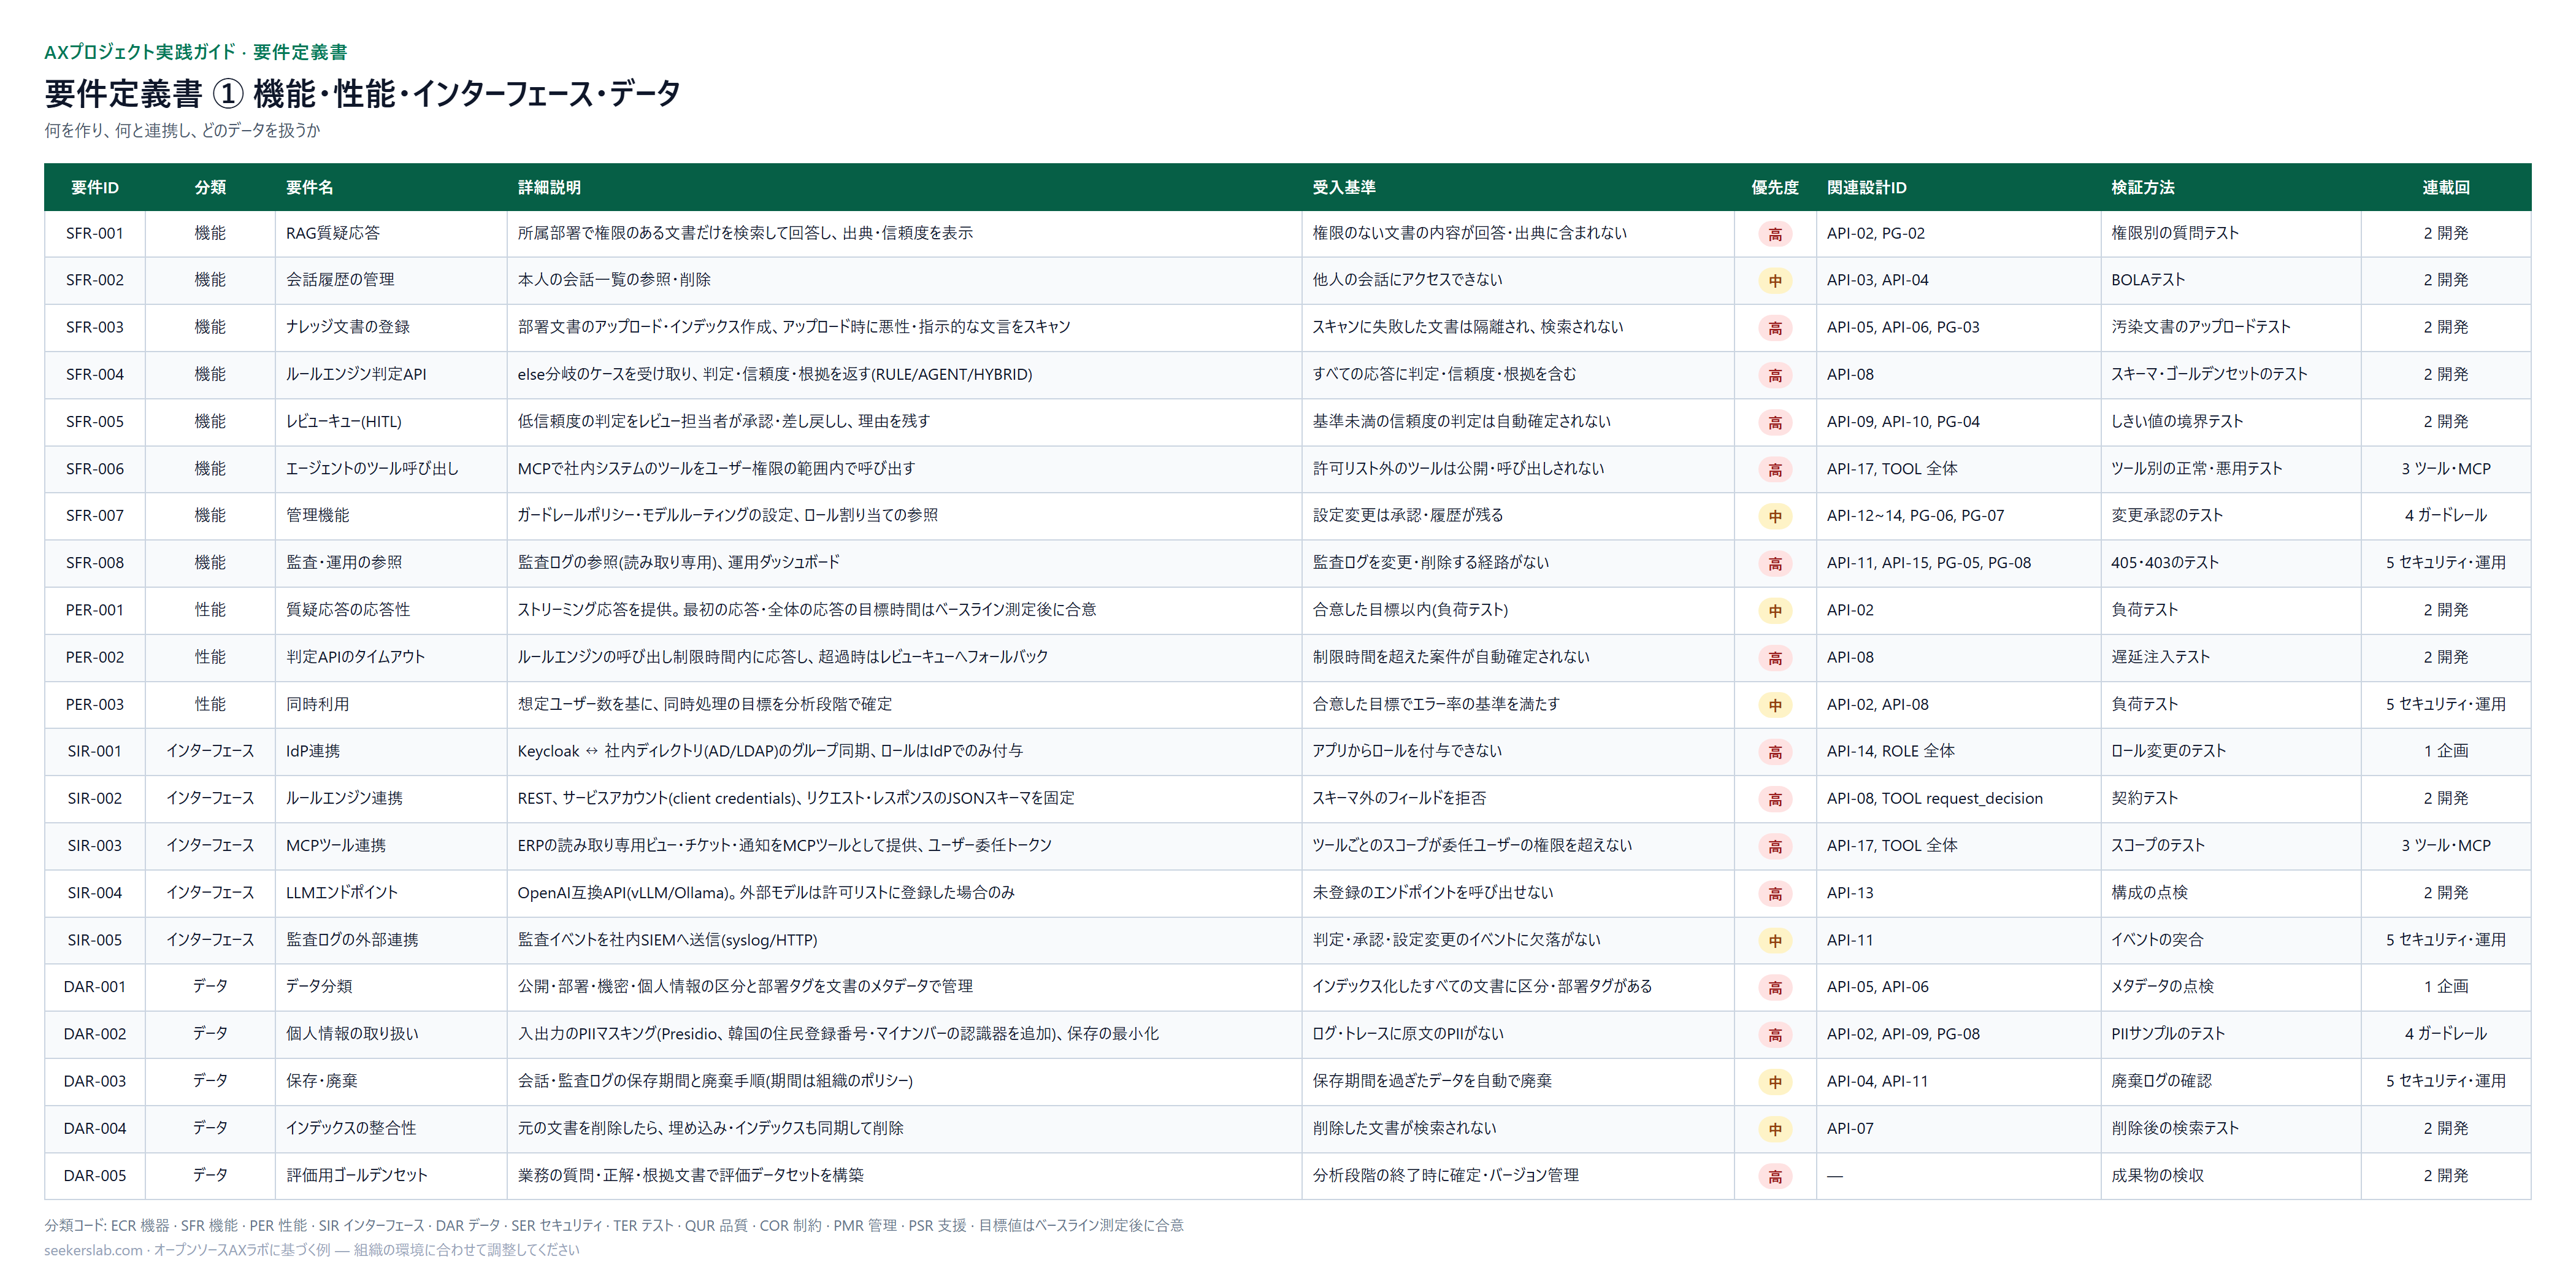 要件定義書 ① 機能・性能・インターフェース・データ — 何を作り、何と連携し、どのデータを扱うか
表で見る: 要件定義書 ① 機能・性能・インターフェース・データ
| 要件ID | 分類 | 要件名 | 詳細説明 | 受入基準 | 優先度 | 関連設計ID | 検証方法 | 連載回 |
|---|---|---|---|---|---|---|---|---|
| SFR-001 | 機能 | RAG質疑応答 | 所属部署で権限のある文書だけを検索して回答し、出典・信頼度を表示 | 権限のない文書の内容が回答・出典に含まれない | 高 | API-02, PG-02 | 権限別の質問テスト | 2 開発 |
| SFR-002 | 機能 | 会話履歴の管理 | 本人の会話一覧の参照・削除 | 他人の会話にアクセスできない | 中 | API-03, API-04 | BOLAテスト | 2 開発 |
| SFR-003 | 機能 | ナレッジ文書の登録 | 部署文書のアップロード・インデックス作成、アップロード時に悪性・指示的な文言をスキャン | スキャンに失敗した文書は隔離され、検索されない | 高 | API-05, API-06, PG-03 | 汚染文書のアップロードテスト | 2 開発 |
| SFR-004 | 機能 | ルールエンジン判定API | else分岐のケースを受け取り、判定・信頼度・根拠を返す(RULE/AGENT/HYBRID) | すべての応答に判定・信頼度・根拠を含む | 高 | API-08 | スキーマ・ゴールデンセットのテスト | 2 開発 |
| SFR-005 | 機能 | レビューキュー(HITL) | 低信頼度の判定をレビュー担当者が承認・差し戻しし、理由を残す | 基準未満の信頼度の判定は自動確定されない | 高 | API-09, API-10, PG-04 | しきい値の境界テスト | 2 開発 |
| SFR-006 | 機能 | エージェントのツール呼び出し | MCPで社内システムのツールをユーザー権限の範囲内で呼び出す | 許可リスト外のツールは公開・呼び出しされない | 高 | API-17, TOOL 全体 | ツール別の正常・悪用テスト | 3 ツール・MCP |
| SFR-007 | 機能 | 管理機能 | ガードレールポリシー・モデルルーティングの設定、ロール割り当ての参照 | 設定変更は承認・履歴が残る | 中 | API-12~14, PG-06, PG-07 | 変更承認のテスト | 4 ガードレール |
| SFR-008 | 機能 | 監査・運用の参照 | 監査ログの参照(読み取り専用)、運用ダッシュボード | 監査ログを変更・削除する経路がない | 高 | API-11, API-15, PG-05, PG-08 | 405・403のテスト | 5 セキュリティ・運用 |
| PER-001 | 性能 | 質疑応答の応答性 | ストリーミング応答を提供。最初の応答・全体の応答の目標時間はベースライン測定後に合意 | 合意した目標以内(負荷テスト) | 中 | API-02 | 負荷テスト | 2 開発 |
| PER-002 | 性能 | 判定APIのタイムアウト | ルールエンジンの呼び出し制限時間内に応答し、超過時はレビューキューへフォールバック | 制限時間を超えた案件が自動確定されない | 高 | API-08 | 遅延注入テスト | 2 開発 |
| PER-003 | 性能 | 同時利用 | 想定ユーザー数を基に、同時処理の目標を分析段階で確定 | 合意した目標でエラー率の基準を満たす | 中 | API-02, API-08 | 負荷テスト | 5 セキュリティ・運用 |
| SIR-001 | インターフェース | IdP連携 | Keycloak ↔ 社内ディレクトリ(AD/LDAP)のグループ同期、ロールはIdPでのみ付与 | アプリからロールを付与できない | 高 | API-14, ROLE 全体 | ロール変更のテスト | 1 企画 |
| SIR-002 | インターフェース | ルールエンジン連携 | REST、サービスアカウント(client credentials)、リクエスト・レスポンスのJSONスキーマを固定 | スキーマ外のフィールドを拒否 | 高 | API-08, TOOL request_decision | 契約テスト | 2 開発 |
| SIR-003 | インターフェース | MCPツール連携 | ERPの読み取り専用ビュー・チケット・通知をMCPツールとして提供、ユーザー委任トークン | ツールごとのスコープが委任ユーザーの権限を超えない | 高 | API-17, TOOL 全体 | スコープのテスト | 3 ツール・MCP |
| SIR-004 | インターフェース | LLMエンドポイント | OpenAI互換API(vLLM/Ollama)。外部モデルは許可リストに登録した場合のみ | 未登録のエンドポイントを呼び出せない | 高 | API-13 | 構成の点検 | 2 開発 |
| SIR-005 | インターフェース | 監査ログの外部連携 | 監査イベントを社内SIEMへ送信(syslog/HTTP) | 判定・承認・設定変更のイベントに欠落がない | 中 | API-11 | イベントの突合 | 5 セキュリティ・運用 |
| DAR-001 | データ | データ分類 | 公開・部署・機密・個人情報の区分と部署タグを文書のメタデータで管理 | インデックス化したすべての文書に区分・部署タグがある | 高 | API-05, API-06 | メタデータの点検 | 1 企画 |
| DAR-002 | データ | 個人情報の取り扱い | 入出力のPIIマスキング(Presidio、韓国の住民登録番号・マイナンバーの認識器を追加)、保存の最小化 | ログ・トレースに原文のPIIがない | 高 | API-02, API-09, PG-08 | PIIサンプルのテスト | 4 ガードレール |
| DAR-003 | データ | 保存・廃棄 | 会話・監査ログの保存期間と廃棄手順(期間は組織のポリシー) | 保存期間を過ぎたデータを自動で廃棄 | 中 | API-04, API-11 | 廃棄ログの確認 | 5 セキュリティ・運用 |
| DAR-004 | データ | インデックスの整合性 | 元の文書を削除したら、埋め込み・インデックスも同期して削除 | 削除した文書が検索されない | 中 | API-07 | 削除後の検索テスト | 2 開発 |
| DAR-005 | データ | 評価用ゴールデンセット | 業務の質問・正解・根拠文書で評価データセットを構築 | 分析段階の終了時に確定・バージョン管理 | 高 | — | 成果物の検収 | 2 開発 |
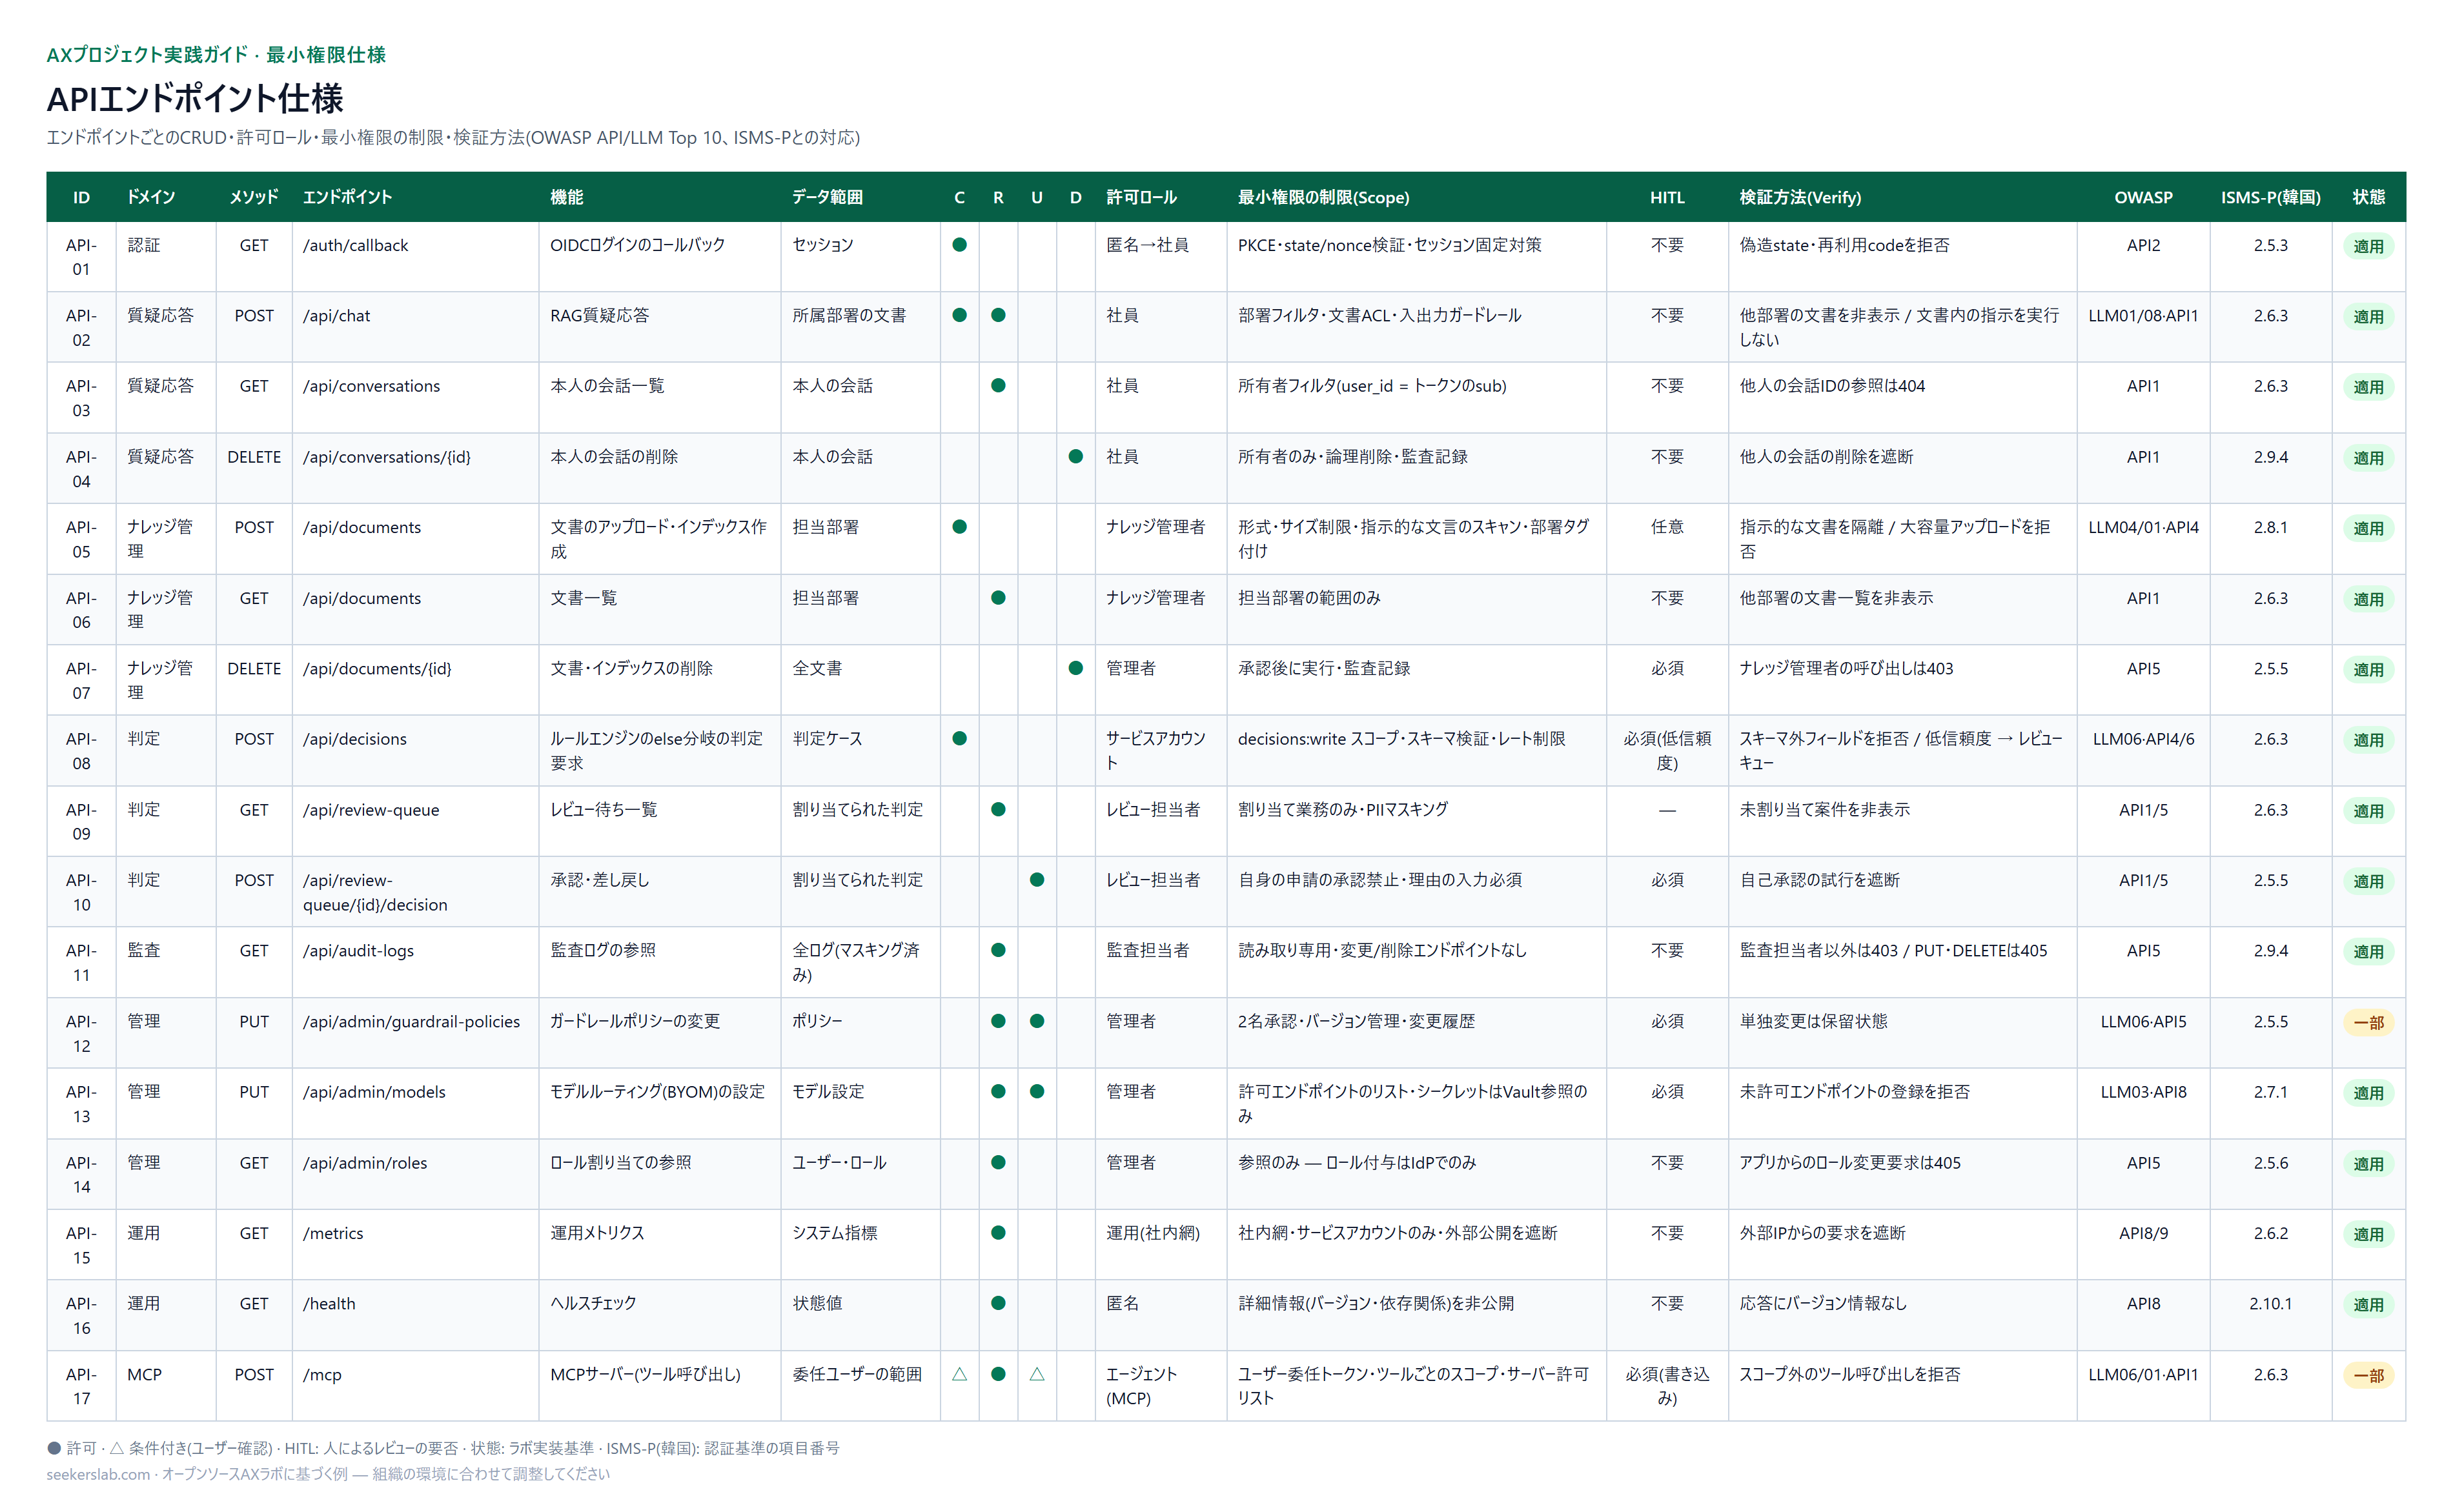 APIエンドポイント仕様 — エンドポイントごとのCRUD・許可ロール・最小権限の制限・検証方法(OWASP API/LLM Top 10、ISMS-Pとの対応)
表で見る: APIエンドポイント仕様
| ID | ドメイン | メソッド | エンドポイント | 機能 | データ範囲 | C | R | U | D | 許可ロール | 最小権限の制限(Scope) | HITL | 検証方法(Verify) | OWASP | ISMS-P(韓国) | 状態 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| API-01 | 認証 | GET | /auth/callback | OIDCログインのコールバック | セッション | ● | 匿名→社員 | PKCE・state/nonce検証・セッション固定対策 | 不要 | 偽造state・再利用codeを拒否 | API2 | 2.5.3 | 適用 | |||
| API-02 | 質疑応答 | POST | /api/chat | RAG質疑応答 | 所属部署の文書 | ● | ● | 社員 | 部署フィルタ・文書ACL・入出力ガードレール | 不要 | 他部署の文書を非表示 / 文書内の指示を実行しない | LLM01/08·API1 | 2.6.3 | 適用 | ||
| API-03 | 質疑応答 | GET | /api/conversations | 本人の会話一覧 | 本人の会話 | ● | 社員 | 所有者フィルタ(user_id = トークンのsub) | 不要 | 他人の会話IDの参照は404 | API1 | 2.6.3 | 適用 | |||
| API-04 | 質疑応答 | DELETE | /api/conversations/{id} | 本人の会話の削除 | 本人の会話 | ● | 社員 | 所有者のみ・論理削除・監査記録 | 不要 | 他人の会話の削除を遮断 | API1 | 2.9.4 | 適用 | |||
| API-05 | ナレッジ管理 | POST | /api/documents | 文書のアップロード・インデックス作成 | 担当部署 | ● | ナレッジ管理者 | 形式・サイズ制限・指示的な文言のスキャン・部署タグ付け | 任意 | 指示的な文書を隔離 / 大容量アップロードを拒否 | LLM04/01·API4 | 2.8.1 | 適用 | |||
| API-06 | ナレッジ管理 | GET | /api/documents | 文書一覧 | 担当部署 | ● | ナレッジ管理者 | 担当部署の範囲のみ | 不要 | 他部署の文書一覧を非表示 | API1 | 2.6.3 | 適用 | |||
| API-07 | ナレッジ管理 | DELETE | /api/documents/{id} | 文書・インデックスの削除 | 全文書 | ● | 管理者 | 承認後に実行・監査記録 | 必須 | ナレッジ管理者の呼び出しは403 | API5 | 2.5.5 | 適用 | |||
| API-08 | 判定 | POST | /api/decisions | ルールエンジンのelse分岐の判定要求 | 判定ケース | ● | サービスアカウント | decisions:write スコープ・スキーマ検証・レート制限 | 必須(低信頼度) | スキーマ外フィールドを拒否 / 低信頼度 → レビューキュー | LLM06·API4/6 | 2.6.3 | 適用 | |||
| API-09 | 判定 | GET | /api/review-queue | レビュー待ち一覧 | 割り当てられた判定 | ● | レビュー担当者 | 割り当て業務のみ・PIIマスキング | — | 未割り当て案件を非表示 | API1/5 | 2.6.3 | 適用 | |||
| API-10 | 判定 | POST | /api/review-queue/{id}/decision | 承認・差し戻し | 割り当てられた判定 | ● | レビュー担当者 | 自身の申請の承認禁止・理由の入力必須 | 必須 | 自己承認の試行を遮断 | API1/5 | 2.5.5 | 適用 | |||
| API-11 | 監査 | GET | /api/audit-logs | 監査ログの参照 | 全ログ(マスキング済み) | ● | 監査担当者 | 読み取り専用・変更/削除エンドポイントなし | 不要 | 監査担当者以外は403 / PUT・DELETEは405 | API5 | 2.9.4 | 適用 | |||
| API-12 | 管理 | PUT | /api/admin/guardrail-policies | ガードレールポリシーの変更 | ポリシー | ● | ● | 管理者 | 2名承認・バージョン管理・変更履歴 | 必須 | 単独変更は保留状態 | LLM06·API5 | 2.5.5 | 一部 | ||
| API-13 | 管理 | PUT | /api/admin/models | モデルルーティング(BYOM)の設定 | モデル設定 | ● | ● | 管理者 | 許可エンドポイントのリスト・シークレットはVault参照のみ | 必須 | 未許可エンドポイントの登録を拒否 | LLM03·API8 | 2.7.1 | 適用 | ||
| API-14 | 管理 | GET | /api/admin/roles | ロール割り当ての参照 | ユーザー・ロール | ● | 管理者 | 参照のみ — ロール付与はIdPでのみ | 不要 | アプリからのロール変更要求は405 | API5 | 2.5.6 | 適用 | |||
| API-15 | 運用 | GET | /metrics | 運用メトリクス | システム指標 | ● | 運用(社内網) | 社内網・サービスアカウントのみ・外部公開を遮断 | 不要 | 外部IPからの要求を遮断 | API8/9 | 2.6.2 | 適用 | |||
| API-16 | 運用 | GET | /health | ヘルスチェック | 状態値 | ● | 匿名 | 詳細情報(バージョン・依存関係)を非公開 | 不要 | 応答にバージョン情報なし | API8 | 2.10.1 | 適用 | |||
| API-17 | MCP | POST | /mcp | MCPサーバー(ツール呼び出し) | 委任ユーザーの範囲 | △ | ● | △ | エージェント(MCP) | ユーザー委任トークン・ツールごとのスコープ・サーバー許可リスト | 必須(書き込み) | スコープ外のツール呼び出しを拒否 | LLM06/01·API1 | 2.6.3 | 一部 |
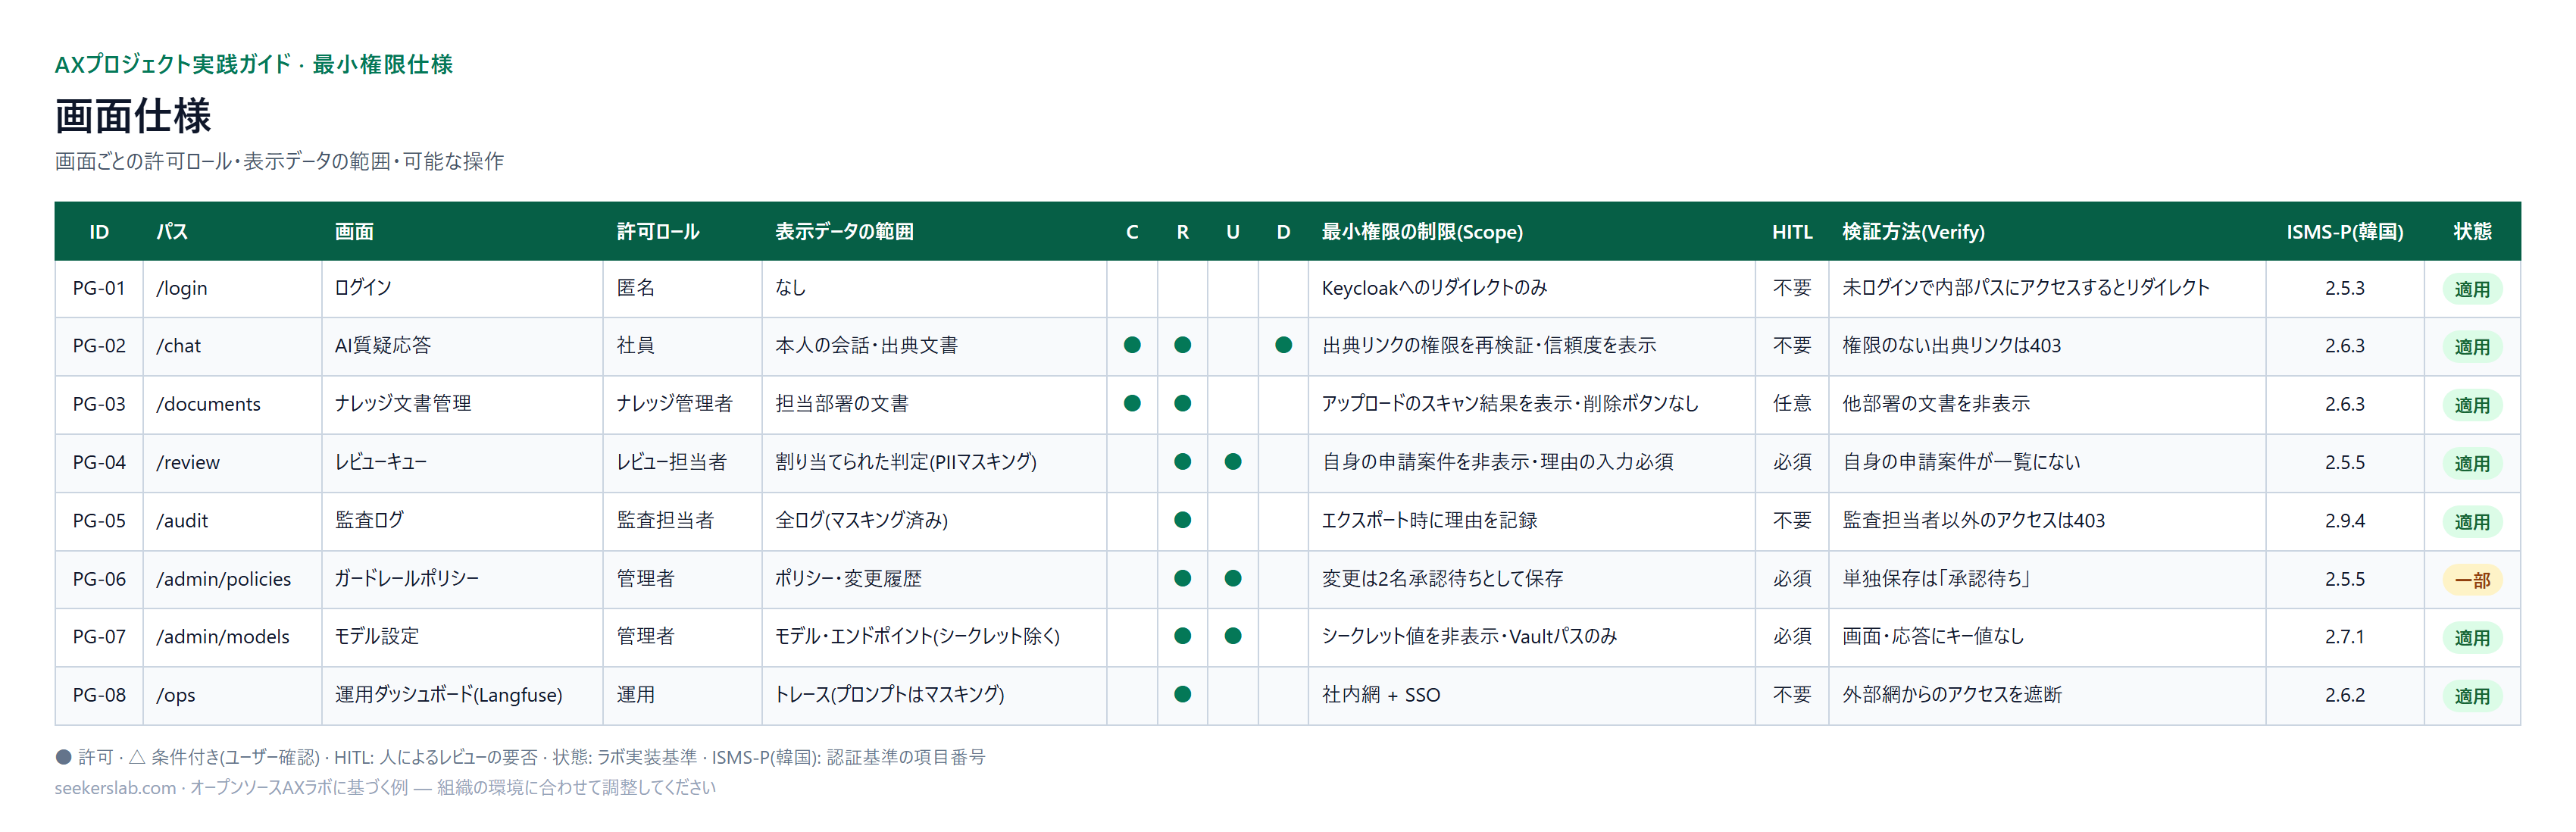 画面仕様 — 画面ごとの許可ロール・表示データの範囲・可能な操作
表で見る: 画面仕様
| ID | パス | 画面 | 許可ロール | 表示データの範囲 | C | R | U | D | 最小権限の制限(Scope) | HITL | 検証方法(Verify) | ISMS-P(韓国) | 状態 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| PG-01 | /login | ログイン | 匿名 | なし | Keycloakへのリダイレクトのみ | 不要 | 未ログインで内部パスにアクセスするとリダイレクト | 2.5.3 | 適用 | ||||
| PG-02 | /chat | AI質疑応答 | 社員 | 本人の会話・出典文書 | ● | ● | ● | 出典リンクの権限を再検証・信頼度を表示 | 不要 | 権限のない出典リンクは403 | 2.6.3 | 適用 | |
| PG-03 | /documents | ナレッジ文書管理 | ナレッジ管理者 | 担当部署の文書 | ● | ● | アップロードのスキャン結果を表示・削除ボタンなし | 任意 | 他部署の文書を非表示 | 2.6.3 | 適用 | ||
| PG-04 | /review | レビューキュー | レビュー担当者 | 割り当てられた判定(PIIマスキング) | ● | ● | 自身の申請案件を非表示・理由の入力必須 | 必須 | 自身の申請案件が一覧にない | 2.5.5 | 適用 | ||
| PG-05 | /audit | 監査ログ | 監査担当者 | 全ログ(マスキング済み) | ● | エクスポート時に理由を記録 | 不要 | 監査担当者以外のアクセスは403 | 2.9.4 | 適用 | |||
| PG-06 | /admin/policies | ガードレールポリシー | 管理者 | ポリシー・変更履歴 | ● | ● | 変更は2名承認待ちとして保存 | 必須 | 単独保存は「承認待ち」 | 2.5.5 | 一部 | ||
| PG-07 | /admin/models | モデル設定 | 管理者 | モデル・エンドポイント(シークレット除く) | ● | ● | シークレット値を非表示・Vaultパスのみ | 必須 | 画面・応答にキー値なし | 2.7.1 | 適用 | ||
| PG-08 | /ops | 運用ダッシュボード(Langfuse) | 運用 | トレース(プロンプトはマスキング) | ● | 社内網 + SSO | 不要 | 外部網からのアクセスを遮断 | 2.6.2 | 適用 |
FAQ
- オープンソースLLMを使用する主な利点は何ですか?
オープンソースLLMは、透明性、ベンダーロックインを回避することによるコスト効率、およびデータプライバシーに対するより優れた制御を提供します。また、コミュニティ主導のイノベーションを促進し、外部にデータを共有することなく独自のデータセットでファインチューニングすることを可能にします。 - RAGはLLMのハルシネーションをどのように軽減しますか?
RAGは、LLMの回答を信頼できるナレッジベースから取得された特定の事実に根拠づけることで、ハルシネーションを軽減します。LLMは事前学習された一般的な知識のみに依存するのではなく、提供されたコンテキストを使用することで、回答をより正確で検証可能なものにします。 - AI統合にとって評価パイプラインが不可欠なのはなぜですか?
評価パイプラインは、AIのパフォーマンスを客観的に測定し、リグレッションを特定し、継続的な改善のためのデータ駆動型インサイトを提供するため、AI統合にとって不可欠です。これにより、AIシステムが時間とともに品質、精度、関連性の基準を一貫して満たすことが保証されます。 - ヒューマン・イン・ザ・ループ(HITL)はAIシステムでどのような役割を果たしますか?
HITLプロセスは、特にリスクの高いシナリオや曖昧なシナリオにおいて、AIの意思決定における人間の監視と介入を可能にします。これにより、精度が向上し、信頼が構築され、モデルのトレーニングと洗練のための貴重なフィードバックが提供され、倫理的で信頼性の高いAI運用が保証されます。 - RAGにpgvectorを使用する利点は何ですか?
pgvectorを使用すると、使い慣れたPostgreSQLデータベース内にベクトル埋め込みを直接保存およびクエリできます。これにより、個別のベクトルデータベースを回避することでインフラストラクチャが簡素化され、既存のPostgreSQLツールを活用し、セマンティック検索とリレーショナルフィルタを組み合わせた強力なハイブリッドクエリが可能になります。
「AXプロジェクト実践ガイド」の第3回では、ツール・MCPフェーズを深く掘り下げ、堅牢なMLOpsフレームワークの確立、AI向けCI/CDパイプライン、およびモデルのガバナンスとライフサイクル管理戦略に焦点を当てます。
← 前の記事: AXプロジェクト実践ガイド 第1回 — 戦略的なAIユースケースの選定と要件定義
次の記事: AXプロジェクト実践ガイド 第3回 — AIエージェントの安全な接続:MCPツール設計、OAuth、防御策のプレイブック →
AXプロジェクトのご相談
既存システムにAIを加えるAXプロジェクトを、ユースケースの選定・要件定義から構築まで、SeekersLabがSI方式でご支援します。導入をご検討中の方はお気軽にお問い合わせください。
- メール: contact@seekerslab.com
- 電話: +82-2-2039-8160(平日 09:00〜18:00、韓国時間)