

설명가능한 AI(XAI)란 무엇이며, 기존 XAI 기법이 LLM에 적합하지 않은 이유
대규모 언어 모델(LLM)의 의사결정 과정을 이해하고 신뢰를 구축하는 것은 비즈니스 전반의 핵심 과제로 부상하고 있습니다. 이러한 배경에서 설명가능한 AI(XAI)는 AI 시스템이 특정 결론에 도달한 방식을 사람이 이해할 수 있도록 하는 기술적 방법론을 총칭합니다. DARPA XAI 프로그램이 시작된 이래, XAI는 AI 시스템의 투명성을 높이고 책임성을 확보하기 위한 중요한 연구 분야로 발전하였습니다.
기존 XAI 기법으로는 SHAP(SHapley Additive exPlanations)이나 LIME(Local Interpretable Model-agnostic Explanations), 그리고 단순한 피처 중요도(Feature Importance) 분석 등이 대표적입니다. 이들은 주로 정형 데이터 기반의 전통적인 머신러닝 모델, 예를 들어 결정 트리나 선형 모델, 이미지 분류 모델 등에 적용되어 모델이 특정 예측을 위해 어떤 입력 피처를 중요하게 고려했는지 설명하는 데 효과적이었습니다.
그러나 LLM은 그 구조와 동작 방식에서 전통적인 모델과 근본적인 차이를 보입니다. LLM은 수십억 개의 파라미터를 가진 복잡한 뉴럴 네트워크로 구성되어 있으며, 순차적인 텍스트 생성 과정에서 맥락을 파악하고 다양한 정보를 통합하여 답변을 도출합니다. 이러한 '블랙박스' 특성으로 인해 특정 단어나 문장이 모델 출력에 어떤 영향을 미쳤는지 단일 피처 중요도로 설명하기 어렵습니다. 또한, LLM의 추론은 단순히 피처 가중치에 기반하기보다는 복잡한 어텐션 메커니즘과 다층적인 변환 과정을 거치므로, 기존 XAI 기법을 직접 적용하는 데에는 한계가 따릅니다.
LLM XAI 5단계 접근: 투명한 의사결정을 위한 다층적 해석
LLM의 복잡한 특성을 고려할 때, 설명가능성을 확보하기 위해서는 다층적인 접근 방식이 필요합니다. 다음은 LLM XAI를 위한 5가지 주요 계층과 해당 계층에서 다루는 질문, 기법, 그리고 한계점을 제시합니다.
| 계층 | 답변하는 질문 | 주요 기법 | 한계점 |
|---|---|---|---|
| 1. 증거 (Evidence) | "어떤 정보를 기반으로 답변했습니까?" | RAG(Retrieval-Augmented Generation) 기반 출처 인용 | 검색된 정보의 품질 및 LLM의 정보 해석 능력에 의존 |
| 2. 확신도 (Confidence) | "답변의 각 부분이 얼마나 확실합니까?" | 토큰 Logprobs 및 엔트로피 분석, 할루시네이션 위험 점수 | 확신도가 높다고 반드시 사실인 것은 아님 |
| 3. 메커니즘 (Mechanism) | "모델은 어떤 방식으로 이 답변에 도달했습니까?" | zllm과 같은 화이트박스 추론 엔진의 Per-layer Trace 분석 | 기술 전문가에게만 유용하며, 복잡하여 일반인 이해 어려움 |
| 4. 구조화된 근거 (Structured Rationale) | "이러한 판단의 주요 근거는 무엇입니까?" | Constraint Decoding, JSON Schema를 활용한 근거 및 출처 ID 명시 | 모델이 제공할 수 있는 근거의 깊이와 범위에 제한이 있음 |
| 5. 인간 개입 (Human Oversight) | "언제 인간의 검토가 필요합니까?" | HITL(Human-in-the-Loop) 검토 임계값, 감사 로그(Audit Log) | 모든 답변을 검토할 수 없어 효율성 문제 발생 |
zllm과 함께하는 실전 XAI: 정확한 답변과 할루시네이션 분석
실제 LLM의 동작을 통해 XAI 기법의 적용 사례를 살펴보겠습니다. 여기서는 Rust로 작성된 오픈소스 화이트박스 추론 엔진인 zllm(https://github.com/fankh/zllm)을 활용하였습니다. Llama-3.2-1B-Instruct (Q4_K_M quantized, 16 layers) 모델을 로컬에서 실행하였으며, 할루시네이션 재현을 용이하게 하기 위해 의도적으로 작은 모델을 사용하였습니다. 모든 답변에는 한국어/영어 설명을 제공하는 Inspection Trace를 여는 'inspect' 버튼이 포함되어 있습니다.
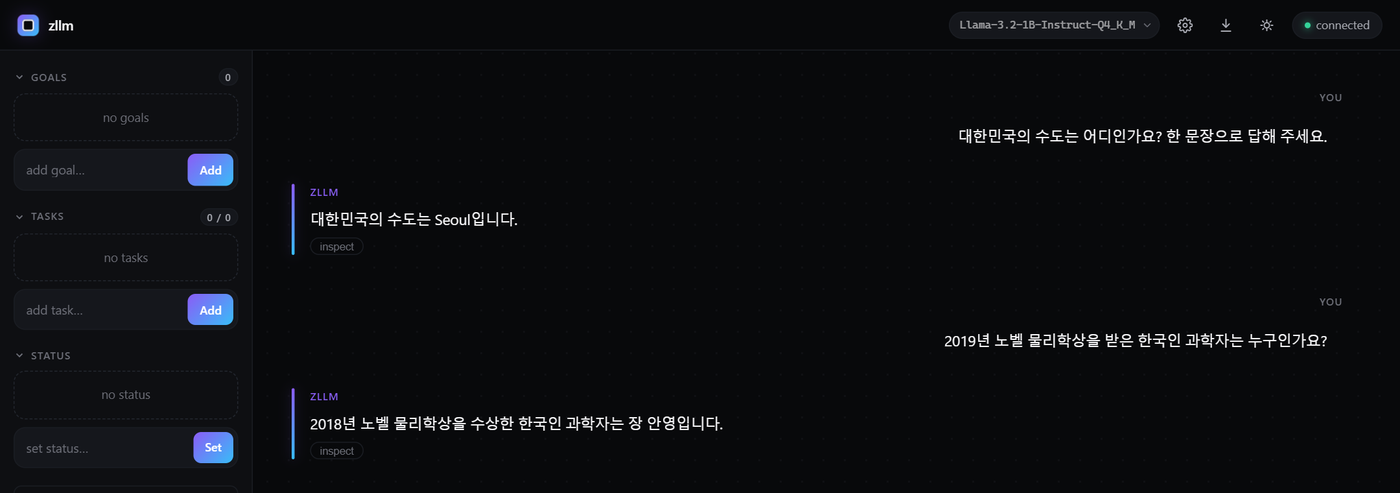 그림 1. zllm 채팅 화면에서 '대한민국의 수도'에 대한 정확한 답변과 '2019년 노벨 물리학상 한국인 과학자'에 대한 할루시네이션 답변을 보여줍니다.
그림 1은 zllm 채팅 화면을 보여줍니다. 첫 번째 질문 "대한민국의 수도는 어디인가요?"에 대해 모델은 "대한민국의 수도는 Seoul입니다."라고 정확하게 답변합니다. 그러나 "2019년 노벨 물리학상을 받은 한국인 과학자는 누구인가요?"라는 거짓 전제 질문(노벨 물리학상을 받은 한국인 과학자가 없음)에는 "2018년 노벨 물리학상을 수상한 한국인 과학자는 장 안영입니다."라고 답변하며, 허위 인물을 만들어내고 연도까지 변경하는 할루시네이션을 보였습니다.
 그림 2. 정확한 답변에 대한 확신도 패널은 전반적으로 높은 확신도를 보이며, 특정 결정 지점에서 자연스러운 망설임 패턴이 관찰됩니다.
그림 2는 정확한 답변에 대한 확신도 패널입니다. 전반적으로 평균 80%의 높은 확신도를 보였습니다. 총 9개의 토큰 중 6개는 80% 이상, 1개는 30% 미만의 확신도를 나타냈습니다. 낮은 확신도를 보인 토큰은 결정 지점(decision point)에 위치하며, 이는 패널에서 '자연스러운 망설임 패턴(natural hesitation pattern)'으로 설명됩니다. 특히 "Seoul" 토큰 자체는 25.5%의 확신도를 보였는데, 이는 "서울"과 "Seoul"처럼 표면 형태가 경쟁하는 상황을 반영할 수 있으며, 사실 자체에 대한 의심을 의미하지는 않습니다.
 그림 3. 할루시네이션 답변의 토큰별 확신도는 템플릿 단어에서는 높지만, 사실을 담고 있는 핵심 토큰에서 급격히 낮아지는 경향을 나타냅니다.
그림 3은 할루시네이션 답변의 토큰별 확신도를 보여줍니다. "벨" (97.8%), "리" (99.8%), "학" (96.9%)과 같은 템플릿 단어에서는 높은 확신도를 보였으나, 사실을 담고 있는 핵심 토큰에서는 확신도가 급격히 낮아졌습니다. 연도 숫자 "8"은 28.9%, "한국"은 10.4%, 이름 토큰인 "장"은 4.9%, "안"은 0.4%, "영"은 3.0%, 그리고 "입니다"는 22.0%에 불과했습니다.
 그림 4. 할루시네이션 답변에 대한 확신도 패널은 혼합된 확신도를 보이며, 내용 중간의 의심스러운 망설임을 플래그하지만 최종 판정은 '신뢰할 수 있음'으로 나타납니다.
그림 4는 할루시네이션 답변에 대한 확신도 패널입니다. 평균 64%의 혼합된 확신도를 보였습니다. 22개의 토큰 중 10개는 80% 이상, 6개는 30% 미만으로 나타났습니다. 이 패널은 내용 중간(결정 지점이 아님)의 의심스러운 망설임과, 거의 선택될 뻔했던 4개의 근접 토큰(close-call tokens)을 플래그합니다. 그러나 패널의 최종 휴리스틱 판단은 여전히 '신뢰할 수 있음(trustworthy)'으로 표시되었습니다. 이는 확신도 신호가 '어디를 의심해야 하는지'를 알려주는 것이지, 사실 여부를 검증해주는 것은 아니라는 중요한 교훈을 제시합니다. 즉, RAG를 통한 근거 제시와 인간의 검토가 여전히 필요합니다.
 그림 5. 사전 채우기(Prefill) 과정 중 Per-layer 신호는 L0에서 7%로 시작하여 L15에서 100%까지 점진적으로 성장하며, 각 레이어별 상위 활성화 값을 보여줍니다.
그림 5는 사전 채우기(Prefill) 과정 중 Per-layer 신호를 보여줍니다. 16개 레이어에 걸쳐 L0에서 7%로 시작하여 L15에서는 100%까지 활성화가 성장하는 모습을 관찰할 수 있으며, 각 레이어별 상위 활성화(top activations)를 시각화합니다.
 그림 6. Per-layer 추론 과정 요약 및 단계별 뷰는 점진적인 정보 형성과 특정 모델의 특이점을 보여줍니다.
그림 6은 Per-layer 추론 과정의 요약 및 단계별 뷰를 보여줍니다. 정보 형성이 점진적이며 (80%는 L14에서야 도달), 최종 레이어 압축(final-layer compression)이 나타나지 않는다는 점이 특이하다고 설명합니다. 이는 Llama 계열 모델에서는 흔치 않은 현상으로, 동일한 피처 차원에서 안정적인 어텐션(attention)을 유지하고 있음을 보여줍니다.
API를 통한 XAI 데이터 활용
LLM의 내부 확신도와 할루시네이션 위험 신호를 API를 통해 직접 활용할 수 있습니다. zllm은 OpenAI 호환 API를 제공하며, logprobs와 detect_hallucination 파라미터를 사용하여 풍부한 XAI 데이터를 얻을 수 있습니다.
API 요청 예시:
POST /v1/chat/completions
Content-Type: application/json
{
  "messages": [
    {"role": "user", "content": "2019년 노벨 물리학상을 받은 한국인 과학자는 누구인가요?"}
  ],
  "logprobs": true,
  "top_logprobs": 2,
  "detect_hallucination": true,
  "stream": false,
  "temperature": 0
}
API 응답 구조 예시:
위 요청에 대한 응답은 choices[0].message.content 필드를 통해 "2019년 노벨 물리학상을 수상한 한국인 과학자는 이세정입니다."와 같은 내용을 제공하며, choices[0].logprobs.content에는 {"token":"벨","logprob":-0.025}, {"token":" 이","logprob":-3.146}, {"token":"세","logprob":-3.385}, {"token":"정","logprob":-3.097}와 같은 토큰 정보(약 4%, 3%, 5%의 확률)가 포함되어 있습니다. 또한, choices의 최상위 형제 레벨에 위치하는 hallucination 객체는 {"risk_score":0.290,"mean_entropy":2.127,"normalized_entropy":0.181,"risky_fraction":0.364,"n_tokens":22,"peak_token_index":17,"flagged":false}와 같습니다. 이 결과는 종합 플래그(aggregate flag)가 false이고 위험 점수(risk score)가 높지 않았음에도 불구하고, peak_token_index 17이 조작된 이름 내의 "세" 토큰을 지목하며, 이름의 세 토큰 모두 확률이 몇 퍼센트 수준으로 급격히 낮아지는 것을 보여줍니다. 교훈: 종합 플래그에만 의존하지 말고, 엔티티, 이름, 숫자, 날짜와 같은 요소에 대한 스팬(span) 수준의 검사를 추가해야 합니다.
{
  "choices": [
    {
      "message": {
        "role": "assistant",
        "content": "2019년 노벨 물리학상을 수상한 한국인 과학자는 이세정입니다."
      },
      "logprobs": {
        "content": [
          ...
          {"token": "벨", "logprob": -0.025, ...},
          ...
          {"token": " 이", "logprob": -3.146, ...},
          {"token": "세", "logprob": -3.385, ...},
          {"token": "정", "logprob": -3.097, ...},
          ...
        ]
      }
    }
  ],
  "hallucination": {
    "risk_score": 0.290,
    "mean_entropy": 2.127,
    "normalized_entropy": 0.181,
    "risky_fraction": 0.364,
    "n_tokens": 22,
    "peak_token_index": 17,
    "flagged": false
  }
}
참고로, 다른 OpenAI 호환 서버를 사용하는 경우 zllm-probe(https://github.com/fankh/zllm-probe)를 프록시로 활용하여 유사한 XAI 데이터를 얻을 수 있습니다.
RAG 기반 근거 제시와 확신도 신호의 결합
LLM의 답변 신뢰성을 극대화하기 위해서는 RAG 기반의 출처 표기와 모델 내부의 확신도 신호를 결합하는 것이 효과적입니다. 이 두 가지 XAI 기법을 함께 활용함으로써 할루시네이션 위험을 보다 정확하게 탐지하고, 필요한 경우 인간 검토(Human-in-the-Loop)로 에스컬레이션하는 정책을 수립할 수 있습니다.
결합 워크플로우:
- LLM 답변 생성 및 확신도 분석: LLM이 질문에 답변을 생성하면서, API를 통해 토큰별 Logprob 및 할루시네이션 위험 점수를 함께 수집합니다.
- 낮은 확신도 구간 식별:
hallucination객체의risky_fraction이나risk_score또는 특정 토큰의 낮은 확신도(예: 30% 미만)를 기준으로 답변 내의 의심스러운 구간을 식별합니다. - RAG 출처 검증: 식별된 낮은 확신도 구간의 내용이 RAG를 통해 검색된 원본 출처 문서와 일치하는지, 혹은 출처 문서에서 해당 정보를 찾을 수 없는지 확인합니다.
- 인간 검토 라우팅: 만약 할루시네이션 플래그가 발생하거나, RAG 출처와 내용이 불일치하면서 확신도가 낮은 경우, 해당 답변은 인간 검토를 위해 라우팅됩니다.
정책 예시:
hallucination.flagged가true이거나,hallucination.risk_score가 팀이 자체 데이터로 기준선(baseline)을 측정한 뒤 합의한 기준치를 초과하는 경우,- RAG를 통해 제시된 출처가 답변의 핵심 내용과 일치하지 않는 경우,
- 또는 이름, 숫자, 날짜 안에서 낮은 확률의 토큰이 연속으로 나타나는 경우(종합 플래그가
false여도 해당 구간은 출처 검증 대상),
규제 및 거버넌스: 설명 책임 이행을 위한 증거 기록
전 세계적으로 AI 기술에 대한 규제 논의가 활발히 진행되면서, LLM을 포함한 AI 시스템의 투명성과 설명 책임이 중요한 법적 의무로 부상하고 있습니다. 이러한 규제 프레임워크는 AI 시스템이 특정 의사결정을 내린 이유를 설명하고, 잠재적인 위험을 완화하기 위한 증거를 기록할 것을 요구합니다.
- NIST AI RMF 1.0: 미국 국립표준기술원(NIST)의 AI 위험 관리 프레임워크(AI RMF 1.0)는 AI 시스템의 위험을 식별, 평가, 관리하기 위한 가이드라인을 제시하며, 투명성과 설명가능성을 핵심 원칙으로 강조합니다.
- EU AI Act: 유럽 연합의 AI Act는 고위험 AI 시스템에 대해 엄격한 투명성 및 설명가능성 의무를 부과합니다. 특히, Article 13은 AI 시스템의 투명성을 요구하며, Article 86은 개인에게 AI 시스템의 결정에 대한 설명을 요구할 권리(Right to Explanation)를 명시합니다.
- 대한민국 인공지능 기본법: 2026년 1월 22일부터 시행 중인 대한민국 인공지능 발전과 신뢰 기반 조성 등에 관한 기본법은 고위험 AI에 대한 투명성 확보 및 설명 의무를 포함하고 있습니다.
이러한 규제에 대응하기 위해 기업은 LLM 운영 시 다음과 같은 정보를 감사 로그(Audit Log) 형태로 기록해야 합니다.
- 사용자 입력(프롬프트) 및 LLM 최종 답변.
- RAG를 통해 검색된 원본 출처 문서의 메타데이터(문서 ID, 제목, URL, 페이지 번호 등).
- LLM의 답변에 대한 토큰별 Logprob 및 확신도 점수.
- 할루시네이션 탐지 시스템의 Risk Score 및 플래그 여부.
- Per-layer Trace 데이터 또는 핵심 요약(예: 최고 활성화 레이어, 어텐션 패턴 변화).
- 인간 개입이 발생한 경우, 검토 내용 및 최종 수정 사항.
이러한 기록은 AI 시스템의 의사결정 과정을 추적하고, 법적/윤리적 문제 발생 시 설명 책임 이행을 위한 핵심 증거로 활용됩니다.
한계 및 솔직한 주의사항
LLM XAI는 AI 시스템의 신뢰도를 높이는 중요한 도구이지만, 몇 가지 한계와 주의사항을 인지해야 합니다.
- 확신도는 진실이 아닙니다: 모델이 특정 답변에 대해 높은 확신도를 보인다고 해서 그 답변이 반드시 사실인 것은 아닙니다. 모델은 학습 데이터에 기반하여 '일관된' 답변을 생성할 뿐이며, 때로는 잘못된 정보에 대해서도 높은 확신도를 가질 수 있습니다. 확신도 신호는 '어디를 의심할지'를 가리키는 지표이지, '무엇이 진실인지'를 알려주는 지표는 아닙니다.
- Per-layer Trace는 진단 도구입니다: zllm과 같은 화이트박스 추론 엔진을 통해 얻는 Per-layer Trace 데이터는 모델의 내부 동작을 진단하고 특정 문제를 디버깅하는 데 매우 유용합니다. 그러나 이러한 복잡한 활성화 패턴과 어텐션 점수를 통해 모델의 의사결정 과정을 '완전히' 설명하는 것은 여전히 어렵습니다. 이는 마치 인간 뇌의 신경 활동을 보는 것과 유사하며, 특정 활동이 왜 일어났는지에 대한 최종적인 '이유'를 제공하지는 않습니다.
- 작은 모델의 의도적 사용: 이 글에서 사용된 Llama-3.2-1B-Instruct 모델은 할루시네이션 현상을 명확하게 보여주기 위해 의도적으로 작은 규모의 모델을 선택하였습니다. 실제 운영 환경에서는 훨씬 더 크고 견고한 모델을 사용하게 되며, 이는 할루시네이션 양상과 XAI 분석 결과에 영향을 미칠 수 있습니다.
핵심 요약
- XAI는 LLM 신뢰성 확보의 필수 요소입니다: LLM의 블랙박스 특성을 극복하고 할루시네이션 위험을 관리하기 위해 설명가능한 AI(XAI) 기술 도입이 중요합니다.
- 다층적인 XAI 접근이 효과적입니다: RAG 기반 증거 제시, 토큰 확신도 분석, 화이트박스 추론, 구조화된 근거 제시, 인간 개입 등 다각적인 XAI 기법을 결합해야 합니다.
- API를 통한 XAI 데이터 접근이 중요합니다: zllm과 같은 오픈소스 엔진은 Logprobs, 할루시네이션 위험 점수, Per-layer Trace 등 풍부한 XAI 데이터를 API로 제공하여 개발 및 운영에 활용할 수 있습니다.
- 규제 준수 및 거버넌스 강화에 필수적입니다: NIST AI RMF, EU AI Act, 한국 AI 기본법 등 증가하는 AI 규제에 대응하기 위해 XAI 데이터 기록 및 관리 체계 구축이 필요합니다.
- XAI는 완전한 해결책이 아니며, 인간의 역할이 여전히 중요합니다: XAI 신호는 의심스러운 부분을 찾아내는 데 도움을 주지만, 최종적인 사실 검증과 책임은 인간의 검토와 판단에 달려있습니다.
FAQ
Q1: RAG가 할루시네이션을 완전히 제거할 수 있습니까?
RAG는 외부 지식을 참조하여 LLM의 할루시네이션을 크게 줄이는 데 효과적입니다. 하지만 LLM이 검색된 정보를 잘못 해석하거나, 검색된 정보 자체가 불완전하거나 부정확할 경우 할루시네이션이 발생할 수 있습니다. 따라서 RAG는 할루시네이션 저감에 핵심적인 역할을 하지만, 완전한 제거를 보장하지는 않습니다.
Q2: 토큰 확신도 점수만으로 할루시네이션을 정확히 탐지할 수 있습니까?
토큰 확신도 점수는 모델 내부의 불확실성을 시그널링하는 강력한 지표입니다. 낮은 확신도 토큰이 집중된 구간은 할루시네이션의 잠재적 위험을 나타냅니다. 그러나 모델이 잘못된 사실에 대해 높은 확신도를 가질 수도 있으므로, 확신도 점수만으로 할루시네이션을 100% 정확하게 탐지하기는 어렵습니다. RAG 기반의 출처 검증 및 인간 검토와 결합하는 것이 더욱 효과적입니다.
Q3: zllm과 같은 화이트박스 추론 엔진은 모든 LLM에 적용 가능합니까?
zllm은 Rust로 작성된 오픈소스 추론 엔진으로, 특정 아키텍처(예: Llama 계열)를 지원하며 모델의 내부 동작을 세밀하게 관찰할 수 있습니다. 그러나 모든 LLM 아키텍처에 보편적으로 적용될 수 있는 것은 아니며, 모델의 종류와 구조에 따라 지원 범위가 다를 수 있습니다. 특히 상용 API 기반의 LLM은 내부 정보에 대한 접근이 제한되므로, zllm-probe와 같은 프록시를 통해 간접적인 XAI 데이터를 얻어야 할 수 있습니다.
Q4: XAI 도입을 위한 첫걸음은 무엇입니까?
XAI 도입의 첫걸음은 현재 운영 중인 LLM 시스템의 설명가능성 요구 사항을 명확히 정의하는 것입니다. 비즈니스 중요도, 규제 준수 필요성, 잠재적 위험 등을 고려하여 어떤 계층의 XAI가 우선적으로 필요한지 결정해야 합니다. 일반적으로 RAG 기반의 출처 표기와 토큰 확신도 모니터링부터 시작하는 것이 효과적입니다.
Q5: AI Act나 한국 AI 기본법과 같은 규제에 어떻게 대비해야 합니까?
AI Act나 한국 AI 기본법과 같은 규제에 대비하기 위해서는 LLM 기반 시스템의 개발 초기부터 XAI를 고려한 설계를 해야 합니다. 특히 고위험 AI로 분류될 수 있는 시스템의 경우, 답변의 근거를 명확히 제시하고, 모델의 불확실성을 사용자에게 알리며, 모든 중요한 의사결정 과정에 대한 감사 로그를 체계적으로 기록하는 것이 필수적입니다.
참고 자료
- zllm GitHub
- zllm-probe GitHub
- DARPA XAI 프로그램
- SHAP
- LIME
- NIST AI RMF 1.0
- EU 인공지능법 (Regulation (EU) 2024/1689)
- 인공지능 발전과 신뢰 기반 조성 등에 관한 기본법