

도입부
새로운 기술을 도입하는 AX 프로젝트의 여정은 항상 새로운 도전과 기회를 동시에 가져옵니다. 지금까지 1편 기획, 2편 개발, 3편 도구·MCP, 4편 가드레일에 걸쳐 AX 프로젝트의 다양한 측면을 살펴보았습니다. 이제 대망의 5편에서는 AI 시스템의 보안, 거버넌스, LLMOps라는 핵심 주제를 다루며 프로젝트의 성공적인 마무리를 위한 실전 가이드를 제시합니다. 특히 SI 프로젝트 관점에서 시험 및 이행 단계에서 필수적으로 점검해야 할 요소와 산출물에 초점을 맞추겠습니다. 통합·권한 시험 결과서, 이행계획서, 운영 매뉴얼, AI 인시던트 런북, 그리고 ISMS-P 증빙 매핑은 이 단계에서 반드시 준비되어야 할 핵심 산출물입니다.
AX 프로젝트 실전 가이드 연재 목차
- AX 프로젝트 실전 가이드 1편 — 기존 시스템에 AI를 더하는 과제 발굴과 요구사항 정의 핵심
- AX 프로젝트 실전 가이드 2편 — 오픈소스 AI로 기존 시스템을 혁신하는 아키텍처 패턴과 평가 파이프라인
- AX 프로젝트 실전 가이드 3편 — MCP 기반 AI 에이전트 안전 연결 및 보안 전략
- AX 프로젝트 실전 가이드 4편 — 오픈소스 LLM 가드레일 설계와 레드팀 시험 완벽 가이드
- AX 프로젝트 실전 가이드 5편 — AI 시스템 보안·거버넌스·LLMOps 실전 가이드 (현재 글)
위협 모델(MITRE ATLAS, OWASP AI Exchange)
AI 시스템의 위협 모델링은 보안 설계의 첫걸음입니다. MITRE ATLAS는 AI 시스템 전반에 걸친 공격 전술과 기법을 분류하여 잠재적 위협을 식별하는 데 매우 효과적입니다. 예를 들어, 모델 무결성 공격(Model Integrity Attack) 전술 아래에는 학습 데이터 오염, 백도어 주입 등의 기법이 존재합니다. 이러한 프레임워크를 활용하면 AI 시스템의 라이프사이클 각 단계에서 발생할 수 있는 위협을 체계적으로 분석할 수 있습니다. OWASP AI Exchange는 웹 애플리케이션의 OWASP Top 10처럼 AI 애플리케이션에 특화된 주요 보안 취약점을 제시하여 개발자들이 흔히 저지르는 실수를 방지하고 안전한 코드를 작성하도록 유도합니다. 이 두 가지를 조합하면 시스템의 취약점을 선제적으로 파악하고, 이에 대한 방어 전략을 수립하는 데 견고한 기반을 마련할 수 있습니다.
다음 표는 AI 시스템의 주요 보안 위협과 그 잠재적 영향을 비교 분석한 내용입니다.
| AI 보안 위협 유형 | 주요 공격 기법 | 예상되는 주요 영향 | 대응 난이도 |
|---|---|---|---|
| 학습 데이터 오염 (Data Poisoning) | 악의적 데이터 주입, 라벨 조작 | 모델 예측 편향, 백도어 생성, 서비스 품질 저하 | 높음 |
| 프롬프트 주입 (Prompt Injection) | 우회 프롬프트, 악의적 명령 주입 | 민감 정보 유출, 오동작, 모델 통제권 상실 | 중간 |
| 모델 탈취 및 재현 (Model Stealing/Extraction) | API 쿼리 공격, 모델 추출 공격 | 지적 재산권 침해, 경쟁력 약화, 새로운 공격 기반 마련 | 높음 |
| 적대적 공격 (Adversarial Attack) | 미세한 입력 변화로 오분류 유도 | 모델 신뢰성 하락, 보안 시스템 우회 (예: 안면 인식) | 높음 |
| 민감 정보 유출 (Data Leakage) | 학습 데이터 내 개인정보 노출, 추론 과정 정보 유출 | 개인정보보호법 위반, 법적 분쟁, 신뢰도 하락 | 중간 |
AI 시스템의 보안 취약점은 단순한 기술적 문제를 넘어 기업의 신뢰도와 재무 성과에 영향을 미칩니다. AI/ML 시스템을 대상으로 한 사이버 공격 시도와 성공률이 증가하는 추세입니다. 특히 AI 모델의 학습 데이터 조작이나 모델 탈취는 예측 불가능한 결과를 초래하며, 잠재적으로 상당한 경제적 손실로 이어질 수 있습니다.
또한, AI 모델의 편향성이나 예측 오류로 인한 의사결정 문제는 규제 당국의 제재와 함께 법적 분쟁의 빌미를 제공할 수 있습니다. 예를 들어, 금융 분야에서 AI 기반 대출 심사 모델의 편향성이 발견될 경우, 이는 차별 문제로 비화되어 벌금과 함께 기업 이미지에 영향을 미칠 수 있습니다. 이러한 사례들은 AI 시스템의 보안과 거버넌스가 단순한 기술적 과제가 아닌, 비즈니스 연속성과 직결되는 핵심 요소임을 명확히 보여줍니다.
공급망 보안(ModelScan·safetensors, Trivy, Syft SBOM, OpenBao, Falco)
AI 모델 개발에 사용되는 오픈소스 라이브러리와 미리 학습된 모델은 AI 시스템의 공급망에서 핵심적인 부분을 차지하지만, 동시에 심각한 보안 취약점의 통로가 될 수 있습니다. 이러한 위험을 해결하기 위해 다음과 같은 오픈소스 도구를 활용할 수 있습니다.
- ModelScan 및 safetensors: AI 모델 파일 자체의 악성 코드를 탐지하고 안전성을 검증하는 데 중요한 역할을 합니다. 특히 safetensors는 모델 가중치를 직렬화하는 안전한 방식을 제공하여 Pickle bomb과 같은 악성 코드 주입을 방지합니다.
- Trivy 및 Syft SBOM: AI 시스템의 컨테이너 이미지, 라이브러리, 의존성 내부에 존재하는 알려진 취약점을 스캔하고 소프트웨어 구성 명세서(SBOM, Software Bill of Materials)를 생성하여 공급망 전반의 가시성을 확보합니다.
- OpenBao (구 Vault): 모델 파라미터, API 키, 민감 데이터 접근 자격 증명과 같은 AI 시스템의 비밀 정보를 안전하게 저장하고 관리하는 데 사용됩니다. 이를 통해 하드코딩된 비밀 정보로 인한 유출 위험을 제거합니다.
- Falco: AI 추론 서버나 학습 환경에서 비정상적인 시스템 호출, 파일 접근, 네트워크 활동 등 런타임 위협을 실시간으로 탐지하여 잠재적인 공격 시도를 즉시 식별합니다.
이러한 오픈소스 도구들은 AI 공급망의 각 단계에서 보안을 강화하며, 사용 전 라이선스 정책을 반드시 확인하여 프로젝트의 법적 리스크를 관리해야 합니다.
데이터 규칙(외부 전송 범위, 보존, 위치)
AI 시스템에서 다루는 데이터는 그 자체로 중요한 자산이자 동시에 주요 공격 대상입니다. AI 시스템의 데이터 거버넌스는 다음 세 가지 핵심 규칙을 중심으로 구축되어야 합니다.
- 외부 전송 범위 제한: 학습 데이터나 추론 결과에 포함된 민감 정보가 불필요하게 외부로 전송되거나 공유되지 않도록 엄격한 정책을 수립해야 합니다. 특히 LLM API 호출 시 사용자 프롬프트나 응답 데이터의 외부 전송 여부 및 익명화 처리 방안을 명확히 정의해야 합니다.
- 데이터 보존 정책: 학습 데이터 및 모델 버전 관리에 필요한 데이터는 정해진 기간 동안 안전하게 보존하고, 개인정보보호법 등 관련 규제에 따라 불필요한 데이터는 적절히 파기하는 정책이 필요합니다. 감사 추적(Audit Trail)을 위해 데이터 변경 이력을 남기는 것도 중요합니다.
- 데이터 저장 위치 명확화: 민감 데이터의 물리적/논리적 저장 위치를 명확히 하고, 해당 위치에 대한 접근 통제 및 암호화를 강화해야 합니다. 클라우드 환경에서는 지역별 데이터 주권(Data Sovereignty) 요구사항을 충족하는지 확인하는 것이 중요합니다.
규제 지도(AI 기본법, 개인정보보호법, ISMS-P / EU AI Act / 일본 AI 추진법·AI 사업자 가이드라인·APPI — 날짜는 원문 확인 안내)
AI 시스템의 규제 준수는 이제 선택이 아닌 필수입니다. AI 서비스의 민감 정보 유출은 개인정보보호법 등 엄격한 규제 준수 문제를 발생시켜 벌금과 소송으로 이어질 가능성이 있습니다. 한국의 AI 기본법(안), 개인정보보호법, 그리고 ISMS-P(정보보호 및 개인정보보호 관리체계)는 AI 시스템의 설계, 개발, 운영 전반에 걸쳐 준수해야 할 중요한 법적/관리적 기준을 제시합니다. 국제적으로는 EU AI Act, 일본의 AI 추진법 및 AI 사업자 가이드라인, 그리고 APPI(개인정보보호법)와 같은 규제 동향을 지속적으로 파악하고 시스템에 반영해야 합니다. 각 규제의 세부 내용은 원문을 확인하여 최신 업데이트를 반영하는 것이 중요합니다. ISMS-P 인증을 위해서는 AI 모델의 학습 데이터 관리, 모델 접근 통제, 추론 결과 검증 등 AI 특화된 보안 통제 항목들을 기존 ISMS-P 프레임워크에 매핑하여 증빙 자료를 마련해야 합니다. 특히 AI 인시던트 대응 절차, LLM 사용 가이드라인 등이 주요 증빙 자료가 될 수 있습니다.
거버넌스(AI 인벤토리, 시스템 카드, 승인 흐름, 감사 추적, AI 인시던트 대응)
효과적인 AI 거버넌스는 AI 시스템의 투명성, 책임성, 신뢰성을 확보하는 핵심입니다.
- AI 인벤토리 및 시스템 카드: 운영 중인 모든 AI 시스템에 대한 상세 정보(목적, 사용 데이터, 모델 종류, 성능 지표, 책임자 등)를 기록한 AI 인벤토리를 구축하고, 각 시스템별 'AI 시스템 카드'를 작성하여 핵심 정보를 한눈에 파악할 수 있도록 합니다.
- 승인 흐름 및 감사 추적: AI 모델 배포, 중요 파라미터 변경, 민감 데이터 접근 등 주요 의사결정 과정에 대한 명확한 승인 절차를 수립하고, 모든 활동에 대한 감사 추적(Audit Trail)을 기록하여 투명성을 확보합니다.
- AI 인시던트 대응: AI 모델의 오작동, 데이터 유출, 편향성 문제 등 AI 특화된 인시던트 발생 시 이를 신속하게 탐지, 분석, 대응할 수 있는 'AI 인시던트 런북'을 마련하고 정기적으로 모의 훈련을 실시해야 합니다.
LLMOps(Langfuse 품질·비용 모니터링, 프롬프트·모델 버전 관리, 섀도·카나리 배포, 드리프트)
LLM 기반 시스템은 그 특성상 지속적인 모니터링과 관리가 필수적입니다. Langfuse와 같은 도구를 활용하여 LLM의 품질, 비용, 지연 시간 등을 실시간으로 모니터링하고 최적화할 수 있습니다. 프롬프트와 모델 버전 관리 시스템은 LLM 애플리케이션의 안정성과 재현성을 보장합니다. 새로운 모델이나 프롬프트 변경 사항을 배포할 때는 섀도(Shadow) 배포나 카나리(Canary) 배포와 같은 점진적 배포 전략을 사용하여 운영 환경에 미치는 영향을 최소화해야 합니다. 또한, 모델 드리프트(Model Drift)를 지속적으로 감지하여 모델 성능 저하를 방지하고, 필요한 경우 재학습을 통해 최신 데이터를 반영할 수 있습니다.
이행 체크리스트
- AI 위협 모델링 (MITRE ATLAS, OWASP AI Exchange) 완료 여부
- AI 공급망 보안 도구 (ModelScan, Trivy, Syft SBOM 등) 적용 및 취약점 검토 완료 여부
- 민감 데이터에 대한 외부 전송, 보존, 위치 규칙 수립 및 준수 여부
- AI 관련 국내외 규제(AI 기본법, 개인정보보호법, EU AI Act 등) 준수 방안 마련 여부
- ISMS-P 증빙을 위한 AI 특화 관리항목 매핑 및 증적 확보 여부
- AI 인벤토리, 시스템 카드, 승인 흐름, 감사 추적 시스템 구축 여부
- AI 인시던트 런북 마련 및 모의 훈련 계획 수립 여부
- LLMOps (품질/비용 모니터링, 버전 관리, 배포 전략) 체계 구축 여부
이 편의 산출물 예시
아래는 오픈소스 AX 랩을 기준으로 작성한 이 단계의 산출물 예시입니다. 조직 환경에 맞게 조정해 사용하세요. 전체 요구사항 정의서(엑셀)는 AX 프로젝트 실전 가이드 허브에서 받을 수 있습니다.
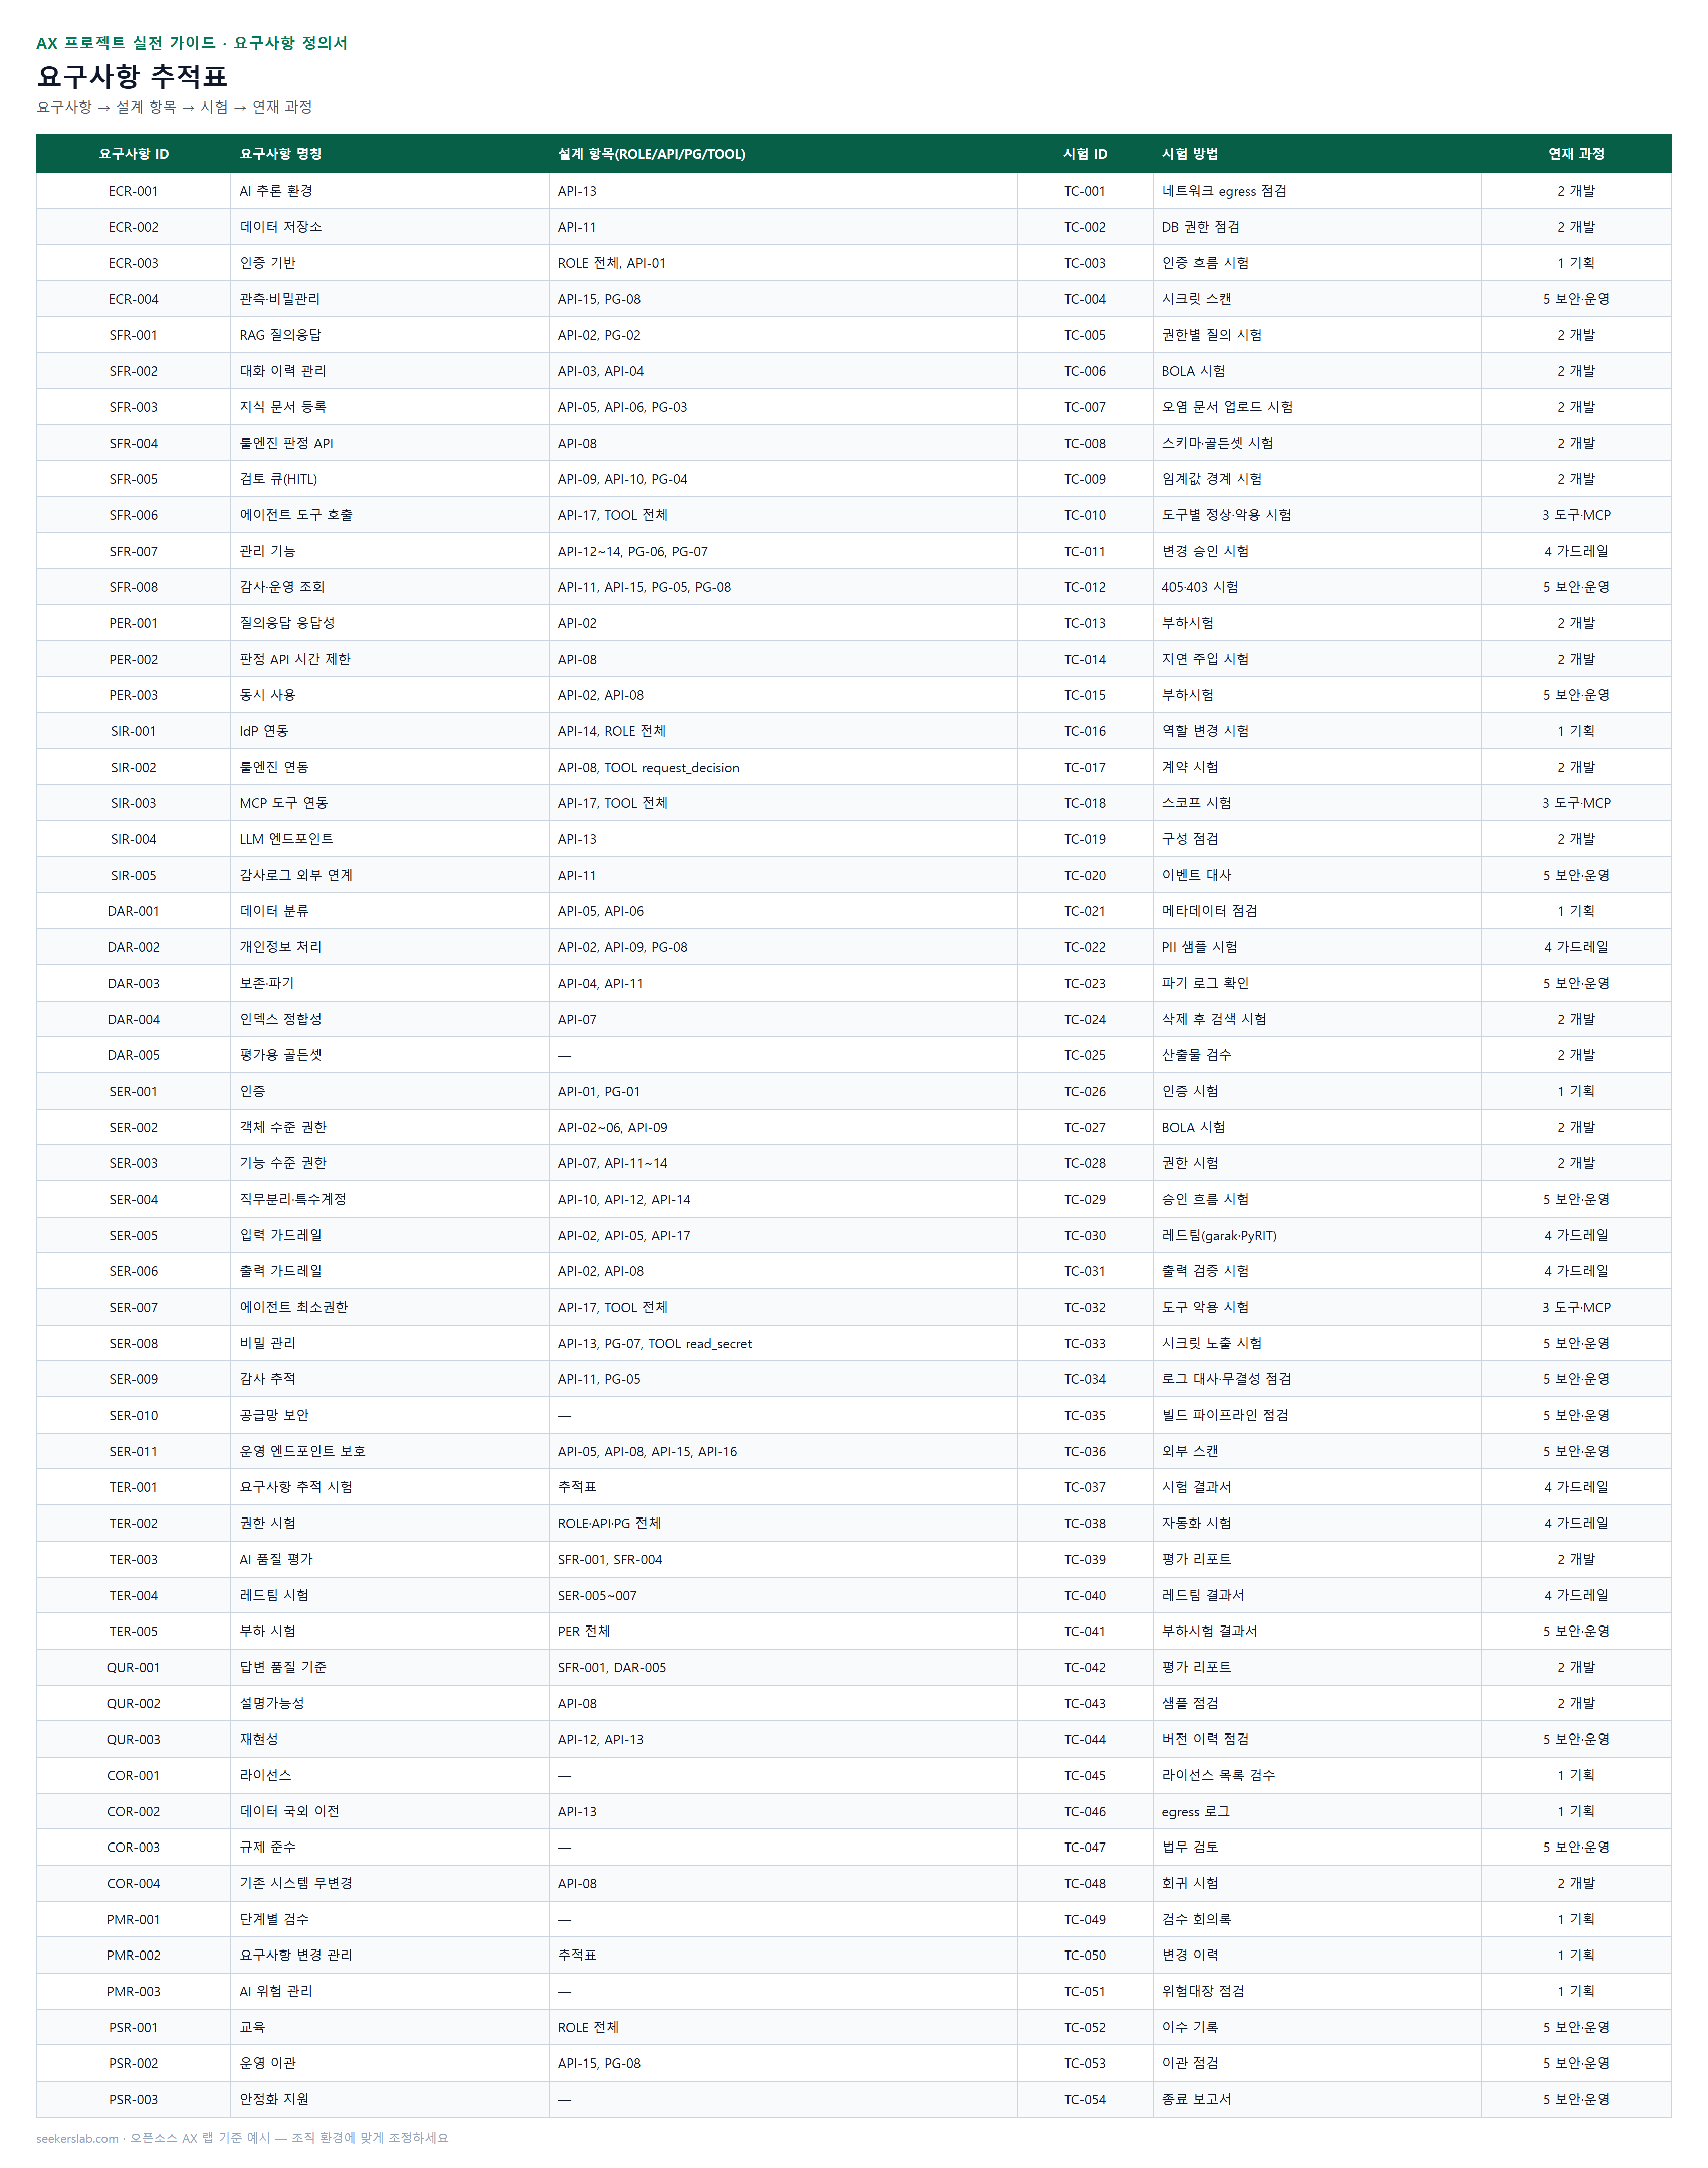 요구사항 추적표 — 요구사항 → 설계 항목 → 시험 → 연재 과정
표로 보기: 요구사항 추적표
| 요구사항 ID | 요구사항 명칭 | 설계 항목(ROLE/API/PG/TOOL) | 시험 ID | 시험 방법 | 연재 과정 |
|---|---|---|---|---|---|
| ECR-001 | AI 추론 환경 | API-13 | TC-001 | 네트워크 egress 점검 | 2 개발 |
| ECR-002 | 데이터 저장소 | API-11 | TC-002 | DB 권한 점검 | 2 개발 |
| ECR-003 | 인증 기반 | ROLE 전체, API-01 | TC-003 | 인증 흐름 시험 | 1 기획 |
| ECR-004 | 관측·비밀관리 | API-15, PG-08 | TC-004 | 시크릿 스캔 | 5 보안·운영 |
| SFR-001 | RAG 질의응답 | API-02, PG-02 | TC-005 | 권한별 질의 시험 | 2 개발 |
| SFR-002 | 대화 이력 관리 | API-03, API-04 | TC-006 | BOLA 시험 | 2 개발 |
| SFR-003 | 지식 문서 등록 | API-05, API-06, PG-03 | TC-007 | 오염 문서 업로드 시험 | 2 개발 |
| SFR-004 | 룰엔진 판정 API | API-08 | TC-008 | 스키마·골든셋 시험 | 2 개발 |
| SFR-005 | 검토 큐(HITL) | API-09, API-10, PG-04 | TC-009 | 임계값 경계 시험 | 2 개발 |
| SFR-006 | 에이전트 도구 호출 | API-17, TOOL 전체 | TC-010 | 도구별 정상·악용 시험 | 3 도구·MCP |
| SFR-007 | 관리 기능 | API-12~14, PG-06, PG-07 | TC-011 | 변경 승인 시험 | 4 가드레일 |
| SFR-008 | 감사·운영 조회 | API-11, API-15, PG-05, PG-08 | TC-012 | 405·403 시험 | 5 보안·운영 |
| PER-001 | 질의응답 응답성 | API-02 | TC-013 | 부하시험 | 2 개발 |
| PER-002 | 판정 API 시간 제한 | API-08 | TC-014 | 지연 주입 시험 | 2 개발 |
| PER-003 | 동시 사용 | API-02, API-08 | TC-015 | 부하시험 | 5 보안·운영 |
| SIR-001 | IdP 연동 | API-14, ROLE 전체 | TC-016 | 역할 변경 시험 | 1 기획 |
| SIR-002 | 룰엔진 연동 | API-08, TOOL request_decision | TC-017 | 계약 시험 | 2 개발 |
| SIR-003 | MCP 도구 연동 | API-17, TOOL 전체 | TC-018 | 스코프 시험 | 3 도구·MCP |
| SIR-004 | LLM 엔드포인트 | API-13 | TC-019 | 구성 점검 | 2 개발 |
| SIR-005 | 감사로그 외부 연계 | API-11 | TC-020 | 이벤트 대사 | 5 보안·운영 |
| DAR-001 | 데이터 분류 | API-05, API-06 | TC-021 | 메타데이터 점검 | 1 기획 |
| DAR-002 | 개인정보 처리 | API-02, API-09, PG-08 | TC-022 | PII 샘플 시험 | 4 가드레일 |
| DAR-003 | 보존·파기 | API-04, API-11 | TC-023 | 파기 로그 확인 | 5 보안·운영 |
| DAR-004 | 인덱스 정합성 | API-07 | TC-024 | 삭제 후 검색 시험 | 2 개발 |
| DAR-005 | 평가용 골든셋 | — | TC-025 | 산출물 검수 | 2 개발 |
| SER-001 | 인증 | API-01, PG-01 | TC-026 | 인증 시험 | 1 기획 |
| SER-002 | 객체 수준 권한 | API-02~06, API-09 | TC-027 | BOLA 시험 | 2 개발 |
| SER-003 | 기능 수준 권한 | API-07, API-11~14 | TC-028 | 권한 시험 | 2 개발 |
| SER-004 | 직무분리·특수계정 | API-10, API-12, API-14 | TC-029 | 승인 흐름 시험 | 5 보안·운영 |
| SER-005 | 입력 가드레일 | API-02, API-05, API-17 | TC-030 | 레드팀(garak·PyRIT) | 4 가드레일 |
| SER-006 | 출력 가드레일 | API-02, API-08 | TC-031 | 출력 검증 시험 | 4 가드레일 |
| SER-007 | 에이전트 최소권한 | API-17, TOOL 전체 | TC-032 | 도구 악용 시험 | 3 도구·MCP |
| SER-008 | 비밀 관리 | API-13, PG-07, TOOL read_secret | TC-033 | 시크릿 노출 시험 | 5 보안·운영 |
| SER-009 | 감사 추적 | API-11, PG-05 | TC-034 | 로그 대사·무결성 점검 | 5 보안·운영 |
| SER-010 | 공급망 보안 | — | TC-035 | 빌드 파이프라인 점검 | 5 보안·운영 |
| SER-011 | 운영 엔드포인트 보호 | API-05, API-08, API-15, API-16 | TC-036 | 외부 스캔 | 5 보안·운영 |
| TER-001 | 요구사항 추적 시험 | 추적표 | TC-037 | 시험 결과서 | 4 가드레일 |
| TER-002 | 권한 시험 | ROLE·API·PG 전체 | TC-038 | 자동화 시험 | 4 가드레일 |
| TER-003 | AI 품질 평가 | SFR-001, SFR-004 | TC-039 | 평가 리포트 | 2 개발 |
| TER-004 | 레드팀 시험 | SER-005~007 | TC-040 | 레드팀 결과서 | 4 가드레일 |
| TER-005 | 부하 시험 | PER 전체 | TC-041 | 부하시험 결과서 | 5 보안·운영 |
| QUR-001 | 답변 품질 기준 | SFR-001, DAR-005 | TC-042 | 평가 리포트 | 2 개발 |
| QUR-002 | 설명가능성 | API-08 | TC-043 | 샘플 점검 | 2 개발 |
| QUR-003 | 재현성 | API-12, API-13 | TC-044 | 버전 이력 점검 | 5 보안·운영 |
| COR-001 | 라이선스 | — | TC-045 | 라이선스 목록 검수 | 1 기획 |
| COR-002 | 데이터 국외 이전 | API-13 | TC-046 | egress 로그 | 1 기획 |
| COR-003 | 규제 준수 | — | TC-047 | 법무 검토 | 5 보안·운영 |
| COR-004 | 기존 시스템 무변경 | API-08 | TC-048 | 회귀 시험 | 2 개발 |
| PMR-001 | 단계별 검수 | — | TC-049 | 검수 회의록 | 1 기획 |
| PMR-002 | 요구사항 변경 관리 | 추적표 | TC-050 | 변경 이력 | 1 기획 |
| PMR-003 | AI 위험 관리 | — | TC-051 | 위험대장 점검 | 1 기획 |
| PSR-001 | 교육 | ROLE 전체 | TC-052 | 이수 기록 | 5 보안·운영 |
| PSR-002 | 운영 이관 | API-15, PG-08 | TC-053 | 이관 점검 | 5 보안·운영 |
| PSR-003 | 안정화 지원 | — | TC-054 | 종료 보고서 | 5 보안·운영 |
FAQ
Q1: AI 시스템의 위협 모델링을 시작할 때 가장 먼저 고려해야 할 사항은 무엇인가요?
AI 시스템의 위협 모델링을 시작할 때는 우선 시스템의 목적, 사용되는 데이터의 민감도, 그리고 모델의 핵심 기능 및 예상되는 사용자 상호작용을 명확히 정의하는 것이 중요합니다. 이를 바탕으로 MITRE ATLAS나 OWASP AI Exchange와 같은 프레임워크를 활용하여 시스템의 공격 표면과 잠재적 위협 벡터를 식별하는 것이 효과적입니다.
Q2: 오픈소스 AI 모델이나 라이브러리를 사용할 때 특히 주의해야 할 보안 측면은 무엇인가요?
오픈소스 AI 모델이나 라이브러리를 사용할 때는 알려진 취약점 여부와 라이선스 정책을 반드시 확인해야 합니다. Trivy와 같은 도구로 종속성 취약점을 스캔하고, ModelScan이나 safetensors를 통해 모델 파일 자체의 무결성을 검증하는 것이 필수적입니다. 또한, 프로젝트의 법적 리스크를 최소화하기 위해 사용 라이선스를 철저히 검토해야 합니다.
Q3: AI 시스템에서 개인정보보호법 준수를 위해 가장 중요한 데이터 규칙은 무엇인가요?
AI 시스템에서 개인정보보호법 준수를 위한 가장 중요한 데이터 규칙은 '최소한의 정보 수집 및 이용', '명확한 동의 획득', '외부 전송 범위 및 보존 기간 제한', '안전한 저장 위치 관리'입니다. 특히 학습 데이터 내 민감 정보를 비식별화하고, 추론 과정에서 개인정보 유출 위험을 최소화하는 기술적, 관리적 통제 방안을 마련해야 합니다.
Q4: ISMS-P 인증을 위해 AI 시스템 운영 시 추가적으로 준비해야 할 증빙 자료는 무엇인가요?
ISMS-P 인증을 위해서는 기존 정보보호 및 개인정보보호 관리체계에 더해 AI 모델 개발 및 운영 라이프사이클 전반에 걸친 보안 통제 증빙이 필요합니다. 예를 들어, 학습 데이터 수집 및 비식별화 절차 기록, 모델 버전 관리 및 배포 승인 기록, AI 인시던트 대응 절차 및 모의 훈련 결과, LLM 사용 가이드라인 등이 주요 증빙 자료로 활용될 수 있습니다.
Q5: LLMOps를 통해 AI 모델의 드리프트(Drift)를 어떻게 효과적으로 감지하고 대응할 수 있나요?
LLMOps에서는 Langfuse와 같은 모니터링 도구를 활용하여 모델의 입력 데이터 분포 변화(Data Drift)나 예측 성능 저하(Concept Drift)를 지속적으로 감지해야 합니다. 이를 위해 특정 지표(예: 응답 품질 점수, 특정 키워드 출현 빈도, 모델 출력의 다양성)에 대한 임계값을 설정하고, 임계값 초과 시 자동 알림을 통해 재학습 또는 모델 교체를 위한 의사결정을 신속하게 수행할 수 있습니다.
다음 편 예고
이번 5편을 마지막으로 AX 프로젝트 실전 가이드 연재를 마무리합니다. AI 기술 도입 여정의 마지막 단계인 보안, 거버넌스, LLMOps의 성공적인 정착을 위한 실질적인 통찰을 제공하고자 노력했습니다. 그동안 연재된 가이드를 통해 여러분의 AX 프로젝트가 더욱 견고하고 성공적으로 추진되기를 기대합니다.
← 이전 글: AX 프로젝트 실전 가이드 4편 — 오픈소스 LLM 가드레일 설계와 레드팀 시험 완벽 가이드
AX 프로젝트 도입 문의
기존 시스템에 AI를 더하는 AX 프로젝트의 과제 발굴, 요구사항 정의, 구축까지 SeekersLab이 SI 방식으로 함께합니다. 도입을 검토 중이라면 문의해 주세요.
- 이메일: contact@seekerslab.com
- 전화: 02-2039-8160 (평일 09:00–18:00)