

이 글은 'AX 프로젝트 실전 가이드' 연재의 세 번째 편으로, AI 에이전트 도입을 위한 여정을 함께하고 있습니다. 전체 연재는 총 5편으로 구성되어 있으며, 1편에서는 프로젝트 기획, 2편에서는 AI 에이전트 개발 방법론을 다루었습니다. 이번 3편에서는 AI 에이전트가 사내 시스템에 안전하게 연결될 수 있도록 핵심 도구인 Model Context Protocol(MCP)을 활용한 인터페이스 설계와 구현 전략에 집중합니다. 이어지는 4편에서는 AI 가드레일, 마지막 5편에서는 보안, 거버넌스, 운영 방안을 심도 있게 다룰 예정입니다.
AX 프로젝트 실전 가이드 연재 목차
- AX 프로젝트 실전 가이드 1편 — 기존 시스템에 AI를 더하는 과제 발굴과 요구사항 정의 핵심
- AX 프로젝트 실전 가이드 2편 — 오픈소스 AI로 기존 시스템을 혁신하는 아키텍처 패턴과 평가 파이프라인
- AX 프로젝트 실전 가이드 3편 — MCP 기반 AI 에이전트 안전 연결 및 보안 전략 (현재 글)
- AX 프로젝트 실전 가이드 4편 — 오픈소스 LLM 가드레일 설계와 레드팀 시험 완벽 가이드
- AX 프로젝트 실전 가이드 5편 — AI 시스템 보안·거버넌스·LLMOps 실전 가이드
MCP 개념: 클라이언트·서버, 도구·자원·프롬프트
AI 에이전트가 사내 시스템의 데이터에 접근하고 기능을 실행하려면, 안전하고 제어 가능한 인터페이스가 필수적입니다. MCP(Model Context Protocol)는 이러한 고민을 해결합니다. MCP는 LLM(Large Language Model) 기반 AI 에이전트가 외부 도구(Tools)와 자원(Resources)을 안전하게 호출할 수 있도록 표준화된 방법을 제공하는 프로토콜입니다. 클라이언트(AI 에이전트)는 MCP 서버에 정의된 도구들을 통해 특정 기능을 수행하고, 서버는 요청을 받아 사내 시스템과 연동하는 게이트웨이 역할을 합니다.
AI 에이전트가 비정형 문서 검색, 데이터베이스 조회, 티켓 시스템 생성 등 다양한 사내 기능을 안전하게 사용할 수 있도록 지원하는 것이 MCP의 핵심 역할입니다. 개발팀에서 가장 만족하는 부분은 MCP가 도구의 스키마와 사용법을 명확히 정의하여 LLM이 도구를 오용하거나 잘못 호출할 가능성을 줄인다는 점입니다. 이처럼 MCP는 AI 에이전트의 활용도를 높이면서도 잠재적인 보안 위협을 관리하는 중요한 기반이 됩니다.
이번 실전 가이드는 SI 프로젝트 관점에서 AI 에이전트의 사내 시스템 연결을 위한 인터페이스 설계 및 구현 단계에 초점을 맞춥니다. 이 과정에서 우리는 인터페이스 정의서, MCP 도구 허용목록(Allowlist), 권한 매트릭스 등의 주요 산출물을 확보하게 될 것입니다. 이러한 산출물은 프로젝트의 명확성과 보안성을 보장하는 데 필수적인 요소입니다.
공식 Python·TypeScript SDK와 MCP Inspector
MCP 기반의 AI 에이전트 연동을 시작하기 전에 몇 가지 핵심 도구를 준비해야 합니다. MCP는 오픈소스 생태계를 통해 활발히 발전하고 있으며, Python과 TypeScript를 위한 공식 SDK를 제공하여 개발자가 쉽게 도구를 정의하고 MCP 서버를 구축할 수 있도록 돕습니다. 사용 전에 각 오픈소스 프로젝트의 라이선스를 반드시 확인하고 준수해야 합니다.
또한, MCP Inspector와 같은 도구는 개발 과정에서 MCP 서버와 도구 정의의 유효성을 검사하는 데 유용합니다. 실제로 MCP Inspector를 사용해 보면, 정의된 도구의 파라미터 유효성이나 응답 형식 일관성 등을 미리 검증하여 개발 시간을 단축하고 오류를 줄이는 데 큰 도움이 된다는 것을 알 수 있습니다. 이외에도, Python 환경 구축을 위한 패키지 관리자가 필요합니다.
MCP 서버 예시: 읽기 전용 DB 뷰, 티켓, 문서 검색
이제 사내 시스템 연동을 위한 간단한 MCP 서버를 구현하는 예시를 살펴보겠습니다. 여기서는 '읽기 전용 데이터베이스 뷰 조회', '내부 티켓 시스템에 문의 사항 등록', '사내 문서 검색'과 같은 시나리오를 가정합니다. 이러한 기능들을 AI 에이전트가 안전하게 호출할 수 있도록 MCP 도구로 정의해 보겠습니다.
다음은 Python을 이용한 간단한 MCP 서버의 초기 설정 코드입니다. 이 코드는 '사내 문서 검색' 기능을 MCP 도구로 정의하는 예시를 보여줍니다.
# main.py
from mcp.server import MCPServer
from mcp.tools import Tool, ToolParam, ToolResponse
from typing import List, Dict
# '사내 문서 검색' 도구 정의
class InternalDocumentSearchTool(Tool):
    name = "internal_document_search"
    description = "사내 문서 시스템에서 특정 키워드로 문서를 검색합니다."
    params = [
        ToolParam(name="query", type=str, description="검색할 키워드"),
        ToolParam(name="max_results", type=int, default=5, description="최대 반환 문서 수"),
    ]
    response = ToolResponse(type=List[Dict[str, str]], description="검색된 문서 목록", properties={
        "title": "문서 제목",
        "url": "문서 URL",
        "snippet": "문서 내용 요약"
    })
    def execute(self, query: str, max_results: int) -> List[Dict[str, str]]:
        # 실제 사내 문서 검색 API 호출 로직 (예시)
        print(f"Searching internal documents for: '{query}' with {max_results} results")
        # 여기에 실제 사내 시스템 연동 코드를 작성합니다.
        # 예시 데이터 반환
        return [
            {"title": "MCP 실전 가이드", "url": "http://docs.example.com/mcp-guide", "snippet": "MCP 프로토콜에 대한 상세 가이드입니다."},
            {"title": "AI 에이전트 보안 원칙", "url": "http://docs.example.com/ai-security", "snippet": "AI 에이전트 개발 시 고려해야 할 보안 사항입니다."}
        ][:max_results]
# MCP 서버 인스턴스 생성 및 도구 등록
mcp_server = MCPServer()
mcp_server.register_tool(InternalDocumentSearchTool())
print("MCP Server and internal_document_search tool initialized.")
print(f"Access the API schema at: {mcp_server.api_schema_url}")
# 실제 서버 실행 (예: FastAPI, Flask 등과 통합)
# 이 예시에서는 서버 인스턴스만 생성하지만, 실제 운영 환경에서는
# ASGI/WSGI 애플리케이션으로 통합하여 HTTP API로 노출해야 합니다.
# (예: `uvicorn main:mcp_server.app --host 0.0.0.0 --port 8000`)
위 코드는 MCP 도구를 정의하고 이를 MCP 서버에 등록하는 기본적인 절차를 보여줍니다. InternalDocumentSearchTool 클래스는 도구의 이름, 설명, 필요한 파라미터, 그리고 예상되는 응답 형식을 명확하게 정의합니다. execute 메서드 안에 실제 사내 시스템과 연동하는 비즈니스 로직을 구현하게 됩니다. 운영팀에서 가장 만족하는 부분은 이렇게 정의된 도구가 명확한 인터페이스를 가지고 있어, AI 에이전트 개발팀과의 커뮤니케이션 비용을 줄이고 예측 가능한 통합을 가능하게 한다는 점입니다.
도구 설계 원칙: 좁은 범위, 타입 지정, 멱등성, Dry-Run, 부작용 명시
AI 에이전트용 도구를 설계할 때는 보안과 안정성을 최우선으로 고려해야 합니다. 다음 원칙들을 지키면 안전하고 효율적인 도구를 만들 수 있습니다. 보안 담당자 입장에서는 도구가 최소한의 권한으로, 예측 가능한 방식으로 동작하는 것이 가장 중요합니다.
| 원칙 | 설명 | 보안/운영적 이점 |
|---|---|---|
| 좁은 범위 (Narrow Scope) | 각 도구는 단일하고 명확한 기능만 수행하도록 설계합니다. | 최소 권한 원칙 준수, 공격 표면 감소, 오용 가능성 최소화. |
| 타입 지정 (Type Specification) | 모든 파라미터와 응답에 명확한 데이터 타입을 지정합니다. | 프롬프트 인젝션 방지, 데이터 유효성 검증 용이, LLM 오해 방지. |
| 멱등성 (Idempotency) | 도구를 여러 번 호출해도 동일한 결과 또는 상태를 유지하도록 설계합니다. (특히 쓰기 작업) | 예기치 않은 부작용 방지, 재시도 메커니즘 안정성 확보. |
| Dry-Run 모드 | 실제 쓰기 작업을 수행하기 전에, 해당 작업이 어떤 영향을 미칠지 미리 시뮬레이션하는 기능을 제공합니다. | 사용자 또는 관리자의 승인 전 최종 확인, 의도치 않은 변경 방지. |
| 부작용 명시 (Explicit Side Effects) | 도구가 시스템 상태를 변경하거나 외부에 영향을 줄 경우, 이를 도구 설명에 명확히 명시합니다. | AI 에이전트의 책임 있는 호출 유도, 감사 추적 용이. |
OAuth(Keycloak) 사용자 위임 토큰, 최소 권한, OPA 정책
AI 에이전트가 특정 사용자를 대신하여 사내 시스템에 접근할 때는 OAuth 2.0과 같은 표준 기반의 위임 모델을 활용해야 합니다. Keycloak과 같은 오픈소스 IAM(Identity and Access Management) 솔루션을 활용하여 사용자 위임 토큰을 발급하고 관리할 수 있습니다. 예를 들어, AI 에이전트가 사용자의 요청에 따라 특정 문서를 검색할 경우, 해당 사용자가 문서 시스템에 접근할 수 있는 권한을 가진 토큰을 에이전트에게 전달하는 방식입니다.
또한, 최소 권한(Least Privilege) 원칙을 철저히 적용해야 합니다. AI 에이전트 또는 MCP 서버가 사내 시스템에 접근하는 데 필요한 최소한의 권한만을 부여합니다. 복잡한 권한 정책은 OPA(Open Policy Agent)와 같은 정책 엔진을 활용하여 중앙에서 관리하고 Enforcement할 수 있습니다. OPA 정책은 '이 도구는 특정 그룹의 사용자만 호출할 수 있고, 특정 데이터만 조회할 수 있다'와 같은 세분화된 규칙을 적용하는 것을 가능하게 합니다.
OPA 정책 예시 (Rego 언어):
package mcp.authz
default allow = false
allow {
    input.user.groups[_] == "finance_team"
    input.tool_name == "get_financial_report"
    input.params.year >= 2023 # 2023년 이후 데이터만 허용
}
allow {
    input.user.roles[_] == "admin"
    # 관리자는 모든 도구에 접근 가능하다고 가정
}
이 OPA 정책은 finance_team 그룹의 사용자만 get_financial_report 도구를 사용할 수 있으며, 2023년 이후 데이터에만 접근을 허용합니다. 또한, admin 역할의 사용자는 모든 도구에 접근할 수 있도록 정의합니다. 이러한 정책을 MCP 서버에 통합하여 모든 도구 호출 전에 권한을 검증할 수 있습니다.
보안 위협: 도구 설명 오염, 프롬프트 인젝션, Confused Deputy, 신뢰할 수 없는 서드파티 서버
AI 에이전트와 사내 시스템을 연결하는 과정에는 다양한 보안 위협이 존재하며, 이에 대한 철저한 대응이 필요합니다. OWASP LLM Top 10에서 언급된 주요 위협들을 중심으로 대응 전략을 수립하는 것이 효과적입니다. 보안 담당자 입장에서는 이러한 위협들이 데이터 유출, 시스템 오작동, 무단 접근으로 이어질 수 있으므로, 선제적인 방어 체계 구축이 관건입니다.
주요 위협:
- 도구 설명 오염 (Tool Description Poisoning): 공격자가 도구 설명을 조작하여 AI 에이전트가 의도치 않은 방식으로 도구를 호출하도록 유도하는 위협입니다.
- 도구 결과를 통한 프롬프트 인젝션 (Prompt Injection via Tool Output): 도구 실행 결과에 악성 프롬프트가 포함되어 LLM이 잘못된 행동을 하도록 유도하는 위협입니다.
- Confused Deputy 공격: AI 에이전트가 신뢰하는 MCP 서버를 악용하여, 에이전트에게 부여된 권한을 넘어선 작업을 수행하도록 강제하는 공격입니다.
- 신뢰할 수 없는 서드파티 서버 연동: 검증되지 않은 외부 MCP 서버 또는 도구를 연동할 경우, 데이터 유출이나 악성 코드 실행의 위험이 있습니다.
보안 위협 대응: 허용목록, 버전 고정, 쓰기 전 사용자 확인, 샌드박스, 로그
- 도구 허용목록(Allowlist) 관리: MCP 서버가 호출할 수 있는 도구들을 엄격하게 관리하고, 승인된 도구만 허용합니다. 이는 인터페이스 정의서와 함께 MCP 도구 허용목록이라는 산출물로 관리됩니다.
- 버전 고정 및 검증: 도구의 버전(예: API 버전)을 고정하고, 변경 시 엄격한 검토 절차를 거쳐 배포합니다. CI/CD 파이프라인에서 정적/동적 분석을 통해 도구의 안전성을 검증하는 것이 필수적입니다.
- 쓰기 전 사용자 확인 (Human-in-the-Loop, HITL): 특히 시스템 상태를 변경하는(쓰기) 도구에 대해서는 AI 에이전트가 실행하기 전에 반드시 최종 사용자의 명시적인 승인을 받도록 설계합니다. 'Dry-Run' 모드를 먼저 실행하여 예상 결과를 보여주고 승인 여부를 묻는 방식이 효과적입니다.
- 샌드박싱 (Sandboxing): MCP 서버와 사내 시스템 연동 로직을 격리된 환경(예: 컨테이너, 가상 머신)에서 실행하여, 잠재적인 위협이 다른 시스템으로 전파되는 것을 막습니다.
- 상세 로그 및 감사 추적: 모든 도구 호출, 파라미터, 결과, 권한 검증 내역을 상세하게 로깅하고, ISMS-P와 같은 보안 규제 준수를 위해 감사 추적(Audit Trail)을 구축합니다.
- 데이터 암호화 및 민감 정보 보호: 데이터 흐름 전반에 걸쳐 암호화(미사용 시 데이터, 전송 중 데이터 모두)를 적용하고, 민감 정보는 마스킹 처리하거나 최소한으로 노출하는 원칙을 지켜야 합니다.
- 보안 규제 준수: ISMS-P 인증과 같은 국내외 보안 프레임워크의 요구사항을 충족하도록 시스템을 설계하고 운영하는 것이 중요합니다.
- 지속적인 보안 강화: 주기적인 보안 취약점 점검, 침투 테스트를 통해 잠재적 약점을 찾아내고 개선하는 노력이 필요합니다. AI 에이전트가 새로운 공격 벡터가 되지 않도록 지속적인 경계와 관리가 필요합니다.
운영 가시성 및 추적성 확보: Langfuse·OpenTelemetry 추적
AI 에이전트가 사내 시스템과 상호작용하는 복잡한 과정은 효과적인 모니터링과 추적 시스템 없이는 관리하기 어렵습니다. Langfuse와 OpenTelemetry와 같은 도구는 이러한 고민을 해결합니다. LLM 에이전트의 모든 상호작용(프롬프트, 도구 호출, 응답, 최종 결과 등)을 상세하게 추적하고 시각화할 수 있도록 지원합니다. 에이전트가 어떤 도구를 언제 호출했고, 어떤 파라미터로 호출했으며, 그 결과는 무엇이었는지 한눈에 파악할 수 있습니다.
OpenTelemetry는 분산 추적(Distributed Tracing)을 위한 표준 프레임워크로, MCP 서버, 백엔드 시스템, AI 에이전트 등 여러 컴포넌트에 걸쳐 요청의 흐름을 통합적으로 볼 수 있게 합니다. 이를 통해 병목 현상이나 오류 지점을 쉽게 식별하고 성능 최적화에 기여할 수 있습니다. Langfuse는 특히 LLM 애플리케이션에 최적화된 트레이싱 솔루션으로, 프롬프트의 품질 평가, A/B 테스트, 에이전트의 의사결정 과정을 분석하는 데 강력한 기능을 제공합니다.
# OpenTelemetry와 Langfuse 연동 예시 코드 스니펫
from opentelemetry import trace
from opentelemetry.sdk.resources import Resource
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import ConsoleSpanExporter, SimpleSpanProcessor
from langfuse import Langfuse
# OpenTelemetry 설정
resource = Resource.create({"service.name": "mcp-server"})
provider = TracerProvider(resource=resource)
processor = SimpleSpanProcessor(ConsoleSpanExporter())
provider.add_span_processor(processor)
trace.set_tracer_provider(provider)
tracer = trace.get_tracer(__name__)
# Langfuse 클라이언트 초기화 (환경 변수 또는 직접 설정)
langfuse = Langfuse()
class MonitoredInternalDocumentSearchTool(InternalDocumentSearchTool):
    def execute(self, query: str, max_results: int) -> List[Dict[str, str]]:
        with tracer.start_as_current_span("mcp_tool_execution", attributes={"tool.name": self.name, "query": query}) as span:
            # Langfuse Trace 시작
            trace_lf = langfuse.trace(name="internal-document-search",
                                      metadata={"user_id": "test_user"})
            # Langfuse Span (tool call) 기록
            span_lf = trace_lf.span(name="execute_search_api",
                                   input={"query": query, "max_results": max_results})
            result = super().execute(query, max_results)
            # Langfuse Span 결과 기록
            span_lf.end(output=result)
            span.set_attribute("result_count", len(result))
            return result
# MCP 서버에 모니터링 기능이 추가된 도구 등록
mcp_server_monitored = MCPServer()
mcp_server_monitored.register_tool(MonitoredInternalDocumentSearchTool())
print("MCP Server with tracing initialized.")
이 코드를 통해 MCP 도구 실행 시 OpenTelemetry 스팬과 Langfuse 트레이스를 동시에 기록할 수 있습니다. 이러한 가시성 확보를 통해 시스템의 동작 방식을 더 깊이 이해하고, 성능 문제 진단 및 보안 이벤트 분석 능력을 향상시킬 수 있습니다. 특히 LLM 기반의 AI 에이전트의 예측 불가능성을 보완하고, 문제가 발생했을 때 근본 원인을 신속하게 찾아내는 데 결정적인 역할을 수행할 수 있습니다.
예상 결과: 구현된 안전한 MCP 연동 시나리오
위에서 제시된 가이드라인과 원칙을 충실히 적용하여 MCP 기반의 AI 에이전트 인터페이스를 구현했다면, 다음과 같은 안전하고 효율적인 연동 시나리오를 기대할 수 있습니다. AI 에이전트는 사용자의 질의를 기반으로 사내 시스템의 특정 데이터를 검색하거나, 업무 요청을 처리하는 데 필요한 도구를 정확하고 안전하게 호출할 것입니다.
예를 들어, 사용자가 '지난주 생산 보고서를 검색해 줘'라고 요청하면, AI 에이전트는 'internal_document_search' 도구를 호출하며, 이때 OPA 정책을 통해 해당 사용자가 보고서에 접근할 권한이 있는지 자동으로 검증합니다. 권한이 확인되면 MCP 서버는 실제 문서 시스템 API를 호출하고, 그 결과를 AI 에이전트에 안전하게 전달하여 사용자에게 요약된 정보를 제공합니다. 만약 '새로운 프로젝트 티켓을 생성해 줘'와 같이 쓰기 작업이 필요한 요청이라면, 에이전트는 사용자에게 최종 승인을 요청하는 과정을 거쳐 의도치 않은 시스템 변경을 방지할 것입니다.
이러한 과정을 통해 데이터 유출이나 무단 접근과 같은 보안 위협이 최소화되고, AI 에이전트는 신뢰할 수 있는 비서 역할을 수행하게 됩니다. 운영팀 입장에서는 모든 도구 호출 기록이 상세히 남아 있어 문제 발생 시 신속하게 원인을 파악하고 대응할 수 있다는 점에서 큰 이점을 얻을 수 있습니다.
문제 해결: 흔히 마주치는 보안 및 통합 과제
MCP 기반 AI 에이전트 시스템을 구축하다 보면 몇 가지 일반적인 문제에 직면할 수 있습니다. 이러한 문제들을 빠르게 해결하는 능력은 프로젝트의 성공에 필수적입니다.
- 인증/권한 실패: AI 에이전트가 MCP 도구를 호출할 때 '권한 없음' 오류가 발생하는 경우입니다. 이는 OAuth 토큰의 만료, 잘못된 스코프 부여, OPA 정책 미적용 또는 정책 오류 등으로 인해 발생할 수 있습니다. 해결책으로는 Keycloak 로그 확인, OPA 정책 디버깅(
opa eval명령어 활용), MCP 서버와 백엔드 시스템 간의 mTLS(mutual TLS) 설정 검토 등이 있습니다. - 도구 정의 불일치: AI 에이전트가 인식하는 도구의 스키마와 MCP 서버에 실제 정의된 도구의 스키마가 일치하지 않아 도구 호출에 실패하는 경우입니다. MCP Inspector를 사용하여 도구 정의 파일(예: OpenAPI 스펙)의 유효성을 검사하고, AI 에이전트가 최신 도구 스키마를 제대로 로드했는지 확인해야 합니다.
- 성능 저하: AI 에이전트의 도구 호출이 빈번하거나 백엔드 시스템의 응답 시간이 길어질 때 전체적인 응답 속도가 느려질 수 있습니다. MCP 서버 내에 캐싱 계층을 도입하거나, 비동기 호출 패턴을 적용하여 백엔드 시스템의 부하를 줄이고 응답성을 개선할 수 있습니다. 불필요한 도구 호출을 줄이도록 AI 에이전트의 프롬프트 엔지니어링을 최적화하는 것도 중요합니다.
- 예기치 않은 도구 부작용: 특히 쓰기 작업을 수행하는 도구에서 예상치 못한 데이터 변경이나 시스템 오류가 발생하는 경우입니다. 도구 설계 원칙에서 강조된 멱등성 및 Dry-Run 모드를 철저히 검토하고, 변경 작업 전에 Human-in-the-Loop(HITL) 검증 단계를 반드시 거치도록 시스템을 보강해야 합니다.
이 편의 산출물 예시
아래는 오픈소스 AX 랩을 기준으로 작성한 이 단계의 산출물 예시입니다. 조직 환경에 맞게 조정해 사용하세요. 전체 요구사항 정의서(엑셀)는 AX 프로젝트 실전 가이드 허브에서 받을 수 있습니다.
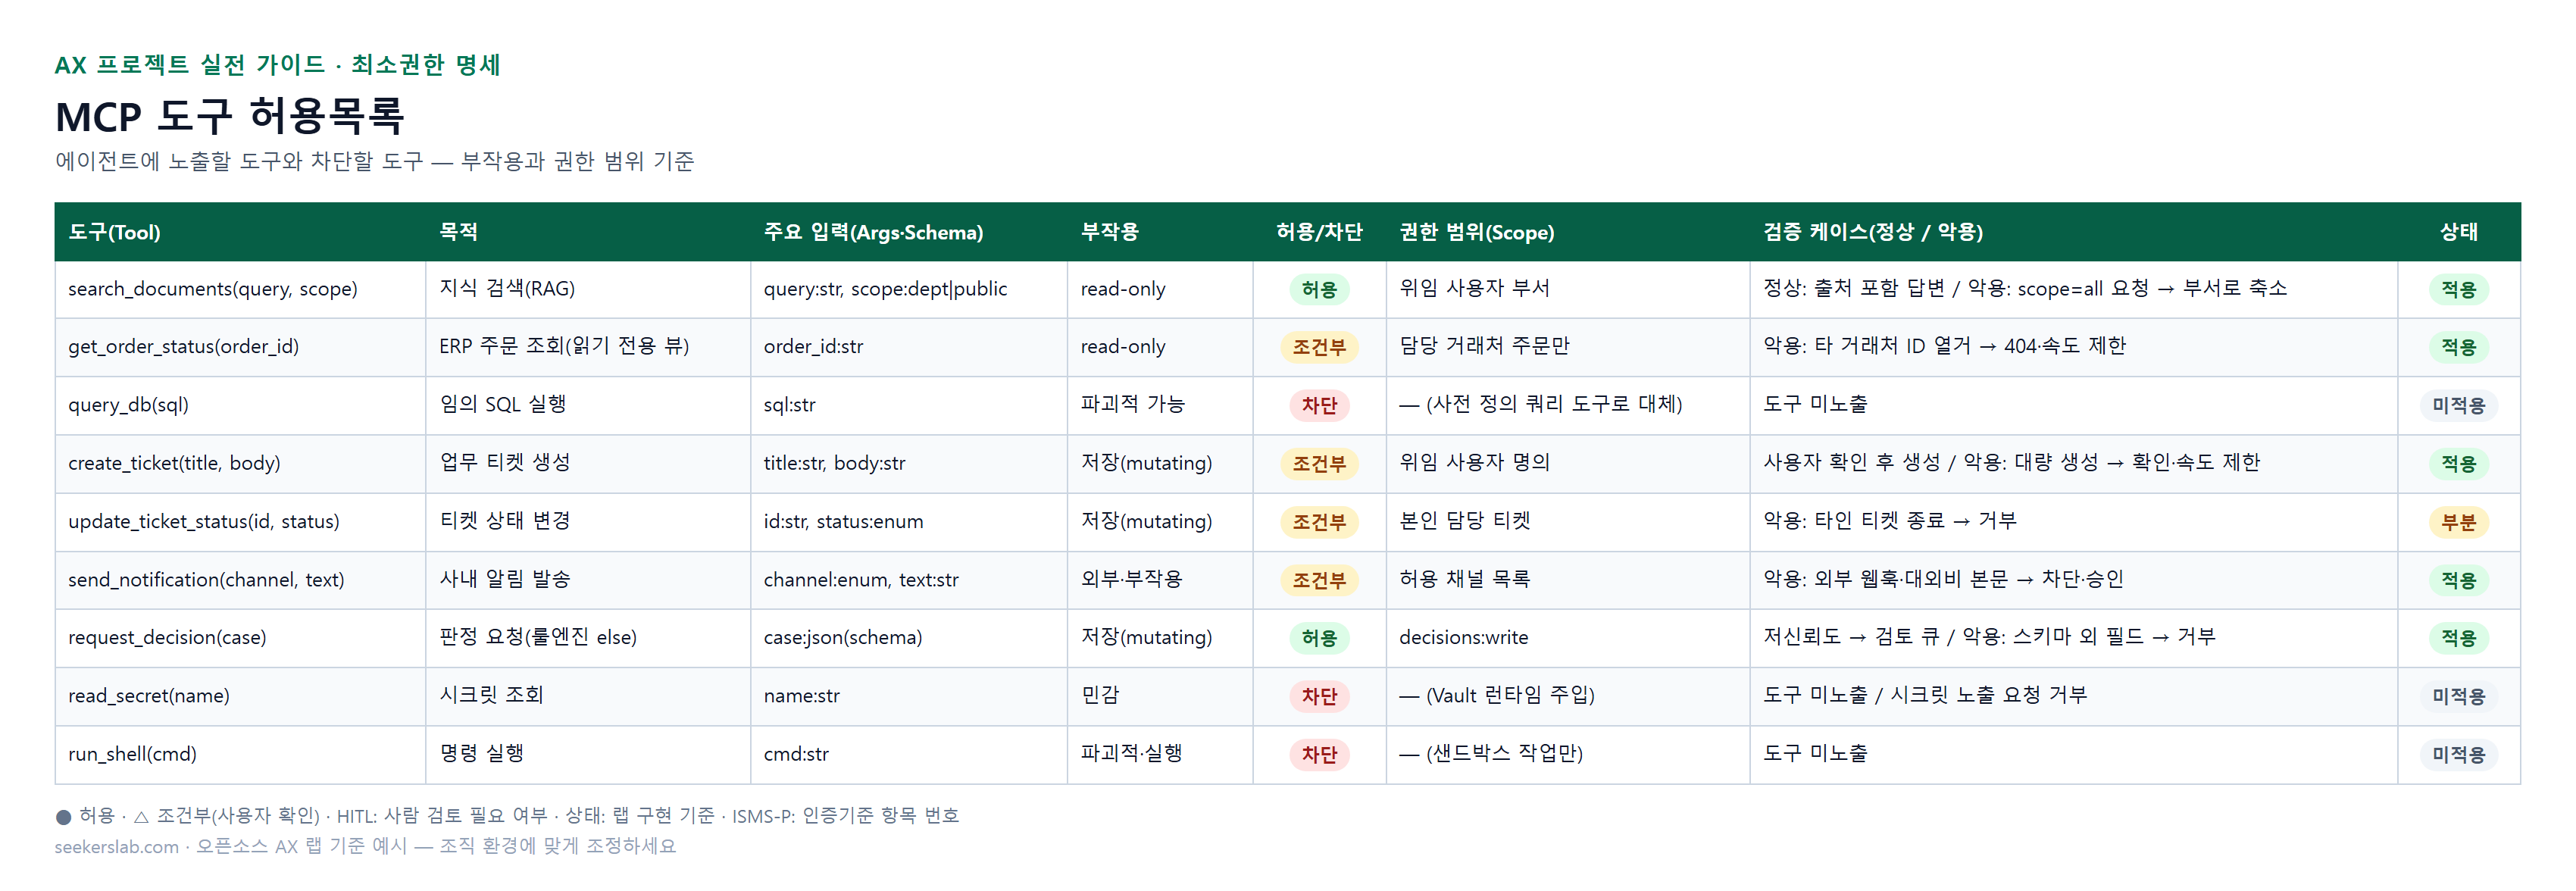 MCP 도구 허용목록 — 에이전트에 노출할 도구와 차단할 도구 — 부작용과 권한 범위 기준
표로 보기: MCP 도구 허용목록
| 도구(Tool) | 목적 | 주요 입력(Args·Schema) | 부작용 | 허용/차단 | 권한 범위(Scope) | 검증 케이스(정상 / 악용) | 상태 |
|---|---|---|---|---|---|---|---|
| search_documents(query, scope) | 지식 검색(RAG) | query:str, scope:dept|public | read-only | 허용 | 위임 사용자 부서 | 정상: 출처 포함 답변 / 악용: scope=all 요청 → 부서로 축소 | 적용 |
| get_order_status(order_id) | ERP 주문 조회(읽기 전용 뷰) | order_id:str | read-only | 조건부 | 담당 거래처 주문만 | 악용: 타 거래처 ID 열거 → 404·속도 제한 | 적용 |
| query_db(sql) | 임의 SQL 실행 | sql:str | 파괴적 가능 | 차단 | — (사전 정의 쿼리 도구로 대체) | 도구 미노출 | 미적용 |
| create_ticket(title, body) | 업무 티켓 생성 | title:str, body:str | 저장(mutating) | 조건부 | 위임 사용자 명의 | 사용자 확인 후 생성 / 악용: 대량 생성 → 확인·속도 제한 | 적용 |
| update_ticket_status(id, status) | 티켓 상태 변경 | id:str, status:enum | 저장(mutating) | 조건부 | 본인 담당 티켓 | 악용: 타인 티켓 종료 → 거부 | 부분 |
| send_notification(channel, text) | 사내 알림 발송 | channel:enum, text:str | 외부·부작용 | 조건부 | 허용 채널 목록 | 악용: 외부 웹훅·대외비 본문 → 차단·승인 | 적용 |
| request_decision(case) | 판정 요청(룰엔진 else) | case:json(schema) | 저장(mutating) | 허용 | decisions:write | 저신뢰도 → 검토 큐 / 악용: 스키마 외 필드 → 거부 | 적용 |
| read_secret(name) | 시크릿 조회 | name:str | 민감 | 차단 | — (Vault 런타임 주입) | 도구 미노출 / 시크릿 노출 요청 거부 | 미적용 |
| run_shell(cmd) | 명령 실행 | cmd:str | 파괴적·실행 | 차단 | — (샌드박스 작업만) | 도구 미노출 | 미적용 |
FAQ
Q1: MCP를 사용하는 가장 큰 이유는 무엇입니까?
A1: MCP는 AI 에이전트가 사내 시스템의 기능과 데이터에 안전하고 예측 가능한 방식으로 접근할 수 있도록 표준화된 인터페이스를 제공합니다. 이를 통해 보안 취약점을 줄이고, 에이전트의 오작동을 방지하며, 개발 및 운영 효율성을 높일 수 있습니다.
Q2: MCP를 구현할 때 가장 중요하게 고려해야 할 보안 원칙은 무엇입니까?
A2: 가장 중요한 원칙은 최소 권한(Least Privilege)과 도구 허용목록(Allowlist) 관리입니다. AI 에이전트와 MCP 도구에 필요한 최소한의 권한만을 부여하고, 승인된 도구만 호출하도록 엄격하게 통제하여 공격 표면을 최소화해야 합니다.
Q3: OAuth와 OPA는 MCP 보안에 어떤 역할을 합니까?
A3: OAuth는 사용자의 권한을 AI 에이전트가 안전하게 위임받아 사내 시스템에 접근할 수 있도록 하는 인증/인가 메커니즘을 제공합니다. OPA는 이러한 위임된 권한 내에서 '누가', '어떤 도구를', '어떤 조건에서' 사용할 수 있는지에 대한 세분화된 정책을 중앙에서 관리하고 적용함으로써, 최소 권한 원칙을 실현하는 데 필수적인 역할을 합니다.
Q4: AI 에이전트의 '쓰기' 작업에 대한 보안 고려사항은 무엇입니까?
A4: 시스템 상태를 변경하는 '쓰기' 작업은 반드시 Human-in-the-Loop(HITL) 검증 단계를 포함해야 합니다. AI 에이전트가 작업을 실행하기 전에 사용자에게 내용을 명확히 제시하고 최종 승인을 받도록 설계하여, 의도치 않은 변경이나 오작동으로 인한 피해를 방지해야 합니다.
Q5: MCP 서버의 성능 모니터링 및 추적은 어떻게 구현합니까?
A5: OpenTelemetry를 활용하여 MCP 서버와 백엔드 시스템 간의 분산 추적을 구현할 수 있습니다. 또한, Langfuse와 같은 LLM 전용 트레이싱 솔루션을 통합하여 AI 에이전트의 프롬프트, 도구 호출, 응답 과정을 상세하게 기록하고 시각화하여 운영 가시성을 확보할 수 있습니다.
결론
이번 'AX 프로젝트 실전 가이드' 3편에서는 AI 에이전트를 사내 시스템에 안전하게 연결하기 위한 MCP 기반의 인터페이스 설계 및 구현 전략을 심도 있게 다루었습니다. MCP의 개념부터 시작하여 도구 설계 원칙, OAuth를 통한 권한 관리, 그리고 주요 보안 위협에 대한 대응 전략까지, 실무에 바로 적용할 수 있는 구체적인 방안들을 제시하였습니다. 이러한 접근 방식은 AI 에이전트의 활용도를 극대화하면서도 사내 시스템의 보안과 안정성을 확보하는 데 핵심적인 역할을 수행할 것입니다. AI 에이전트 프로젝트의 성공은 이러한 기술적 가치를 비즈니스 언어로 번역하고, 실제 고객 사례와 ROI 분석을 통해 설득력을 얻는 과정에서 완성됩니다. 다음 편인 4편에서는 AI 에이전트의 오작동과 오용을 방지하기 위한 '가드레일' 구축 방안에 대해 자세히 살펴보겠습니다.
← 이전 글: AX 프로젝트 실전 가이드 2편 — 오픈소스 AI로 기존 시스템을 혁신하는 아키텍처 패턴과 평가 파이프라인
다음 글: AX 프로젝트 실전 가이드 4편 — 오픈소스 LLM 가드레일 설계와 레드팀 시험 완벽 가이드 →
AX 프로젝트 도입 문의
기존 시스템에 AI를 더하는 AX 프로젝트의 과제 발굴, 요구사항 정의, 구축까지 SeekersLab이 SI 방식으로 함께합니다. 도입을 검토 중이라면 문의해 주세요.
- 이메일: contact@seekerslab.com
- 전화: 02-2039-8160 (평일 09:00–18:00)