

企業環境における大規模言語モデル(LLM)の普及は、前例のない能力をもたらすと同時に、特にその透明性、信頼性、セキュリティに関して複雑な課題を提起しています。LLMは人間のようなテキスト生成に優れている一方で、その「ブラックボックス」的な性質は、出力の背後にある推論をしばしば不明瞭にし、信頼性、コンプライアンス、ガバナンスにとって大きな障壁となっています。この可視性の欠如は、機密性の高いアプリケーションにAIシステムを導入する組織にとって重要な懸念事項であり、モデルの動作を理解し検証するための堅牢なメカニズムが不可欠です。
説明可能なAI(XAI)は、AIシステムの意思決定を人間が理解できるようにするための方法とツールを提供する極めて重要な分野として浮上しています。LLMにとって、XAIは単なる望ましいものではなく、必須のものです。これにより、ステークホルダーはモデルの応答を監査し、ハルシネーションを検出し、バイアスを軽減し、敵対的攻撃から防御することができます。従来のLLM展開は入出力関係に焦点を当てがちですが、モデルの内部動作に関する比類のない洞察を提供する、より深い「ホワイトボックス」アプローチが注目を集めています。本稿では、オープンソースのホワイトボックス推論エンジンであるzllmの機能を通じて、LLM向けの実践的なXAI技術を掘り下げ、透明で安全なAI展開を促進するその有用性を強調します。
XAIとは何か、そしてなぜ従来のXAIがLLMにうまく適合しないのか
説明可能なAI(XAI)は、DARPA XAIイニシアチブのようなプログラムによって最初に体系化された分野であり、AIモデルをより透明で解釈可能にすることに焦点を当てています。その目標は、技術的意思決定者がAIシステムの出力の背後にある推論を理解し、エラーを診断し、公平性を確保し、規制要件に準拠できるようにすることです。
従来の機械学習モデルの場合、SHAP(SHapley Additive exPlanations)やLIME(Local Interpretable Model-agnostic Explanations)などの古典的なXAI技術は、特徴量の重要度を定量化することで貴重な洞察を提供します。これらの手法は通常、モデルの予測に最も貢献する入力特徴量を特定します。しかし、これらの技術を大規模言語モデルに直接適用するには、重大な課題があります。
LLMは根本的に異なる原理で動作します。これらは、静的な特徴量ベクトルではなく、複雑で動的な内部状態に依存して、トークンを次々に生成するシーケンシャルな生成モデルです。LLMにおける「特徴量」は、生成される各トークンとともに動的に変化する高次元の埋め込みと文脈的関係です。したがって、SHAPやLIMEが行うように、最終出力を静的な入力特徴量に帰属させることは、LLMの生成に内在する複雑な段階的な推論と広範な文脈的依存関係を捉えることができません。その動的で高度に文脈的な性質は、その膨大なサイズと創発的な特性と相まって、古典的な特徴量重要度に基づくXAI手法ではLLMの動作を真に説明するには不十分です。
5つのレイヤーで理解するLLM XAI
LLMに効果的なXAIを適用するには、外部のエビデンスから内部メカニズム、人間による監視に至るまで、モデル動作のさまざまな側面に対処する多層的なアプローチが必要です。これらのレイヤーを構造化して以下に示します。
| レイヤー | 問い | 手法 | 限界 |
|---|---|---|---|
| 1. エビデンス | 回答は事実に基づいているか? | 情報源引用付きのRAG (Retrieval-Augmented Generation) | 誤解釈や「合成」エラーは検出しない。取得した情報源の質に依存する。 |
| 2. 確信度 | モデルは回答の各部分にどれほど確信を持っているか? | トークンのログ確率、エントロピー、ハルシネーションリスクスコア | 高い確信度は真実を保証しない。低い確信度は疑うべき「場所」を示すが、「何が」間違っているかは示さない。 |
| 3. メカニズム | モデルはこの特定の出力にどのように到達したか? | レイヤーごとの内部トレース(ホワイトボックス推論) | 高次元かつ複雑。診断的であり、「推論」の直接的な人間が読める説明ではない。 |
| 4. 構造化された根拠 | モデルは自身の推論と情報源を明確に説明できるか? | 制約付きデコーディング、理由と引用された情報源ID用のJSONスキーマ | モデルが生成した根拠は、真の推論パスではなく、事後的な正当化である可能性がある。 |
| 5. 人間による監視 | 人間によるレビューと介入のメカニズムはあるか? | Human-in-the-Loop (HITL) レビュー閾値、コンプライアンスのための監査ログ | スケーラビリティの課題。人間のバイアスがレビュー結果に影響を与える可能性がある。明確なポリシーが必要。 |
zllmによる実践:正しい回答とハルシネーションされた回答
LLM XAIの実践を説明するために、Rustで書かれたオープンソースのホワイトボックス推論エンジンであるzllm(https://github.com/fankh/zllm)を用いたシナリオを検証します。このデモンストレーションでは、16層のLlama-3.2-1B-InstructのQ4_K_M量子化モデルをローカルで実行しています。ハルシネーションを再現しやすくするために、意図的に小さなモデルを選択しました。zllmで生成されたすべての回答には「検査」ボタンが含まれており、英語の説明付きの詳細な検査トレースが開きます。
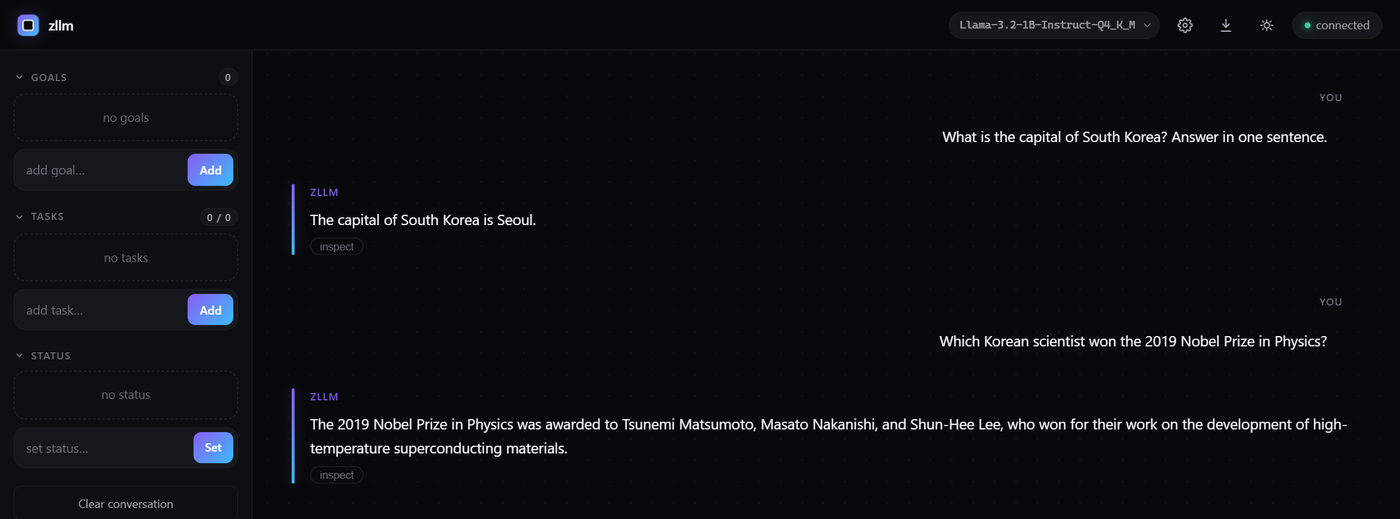 図1. LLMによる正しい回答とハルシネーションされた回答を表示するチャット画面。Q1「What is the capital of South Korea? Answer in one sentence.」(韓国の首都はどこですか?一文で答えてください。)に対し、モデルは「The capital of South Korea is Seoul.」(韓国の首都はソウルです。)と正しく回答しました。Q2「Which Korean scientist won the 2019 Nobel Prize in Physics?」(2019年のノーベル物理学賞を受賞した韓国人科学者は誰ですか?)という誤った前提の質問に対し、モデルは「The 2019 Nobel Prize in Physics was awarded to Tsunemi Matsumoto, Masato Nakanishi, and Shun-Hee Lee, who won for their work on the development of high-temperature superconducting materials.」(2019年のノーベル物理学賞は、高温超電導材料の開発に関する業績により、松本経美、中西正人、イ・スンヒに授与されました。)と、架空の人物と研究を作り出して回答しました。
2つのユーザーからの質問を検討します。まず、事実に関する質問として「What is the capital of South Korea? Answer in one sentence.」(韓国の首都はどこですか?一文で答えてください。)と尋ねました。モデルは「The capital of South Korea is Seoul.」(韓国の首都はソウルです。)と正しく応答しました。
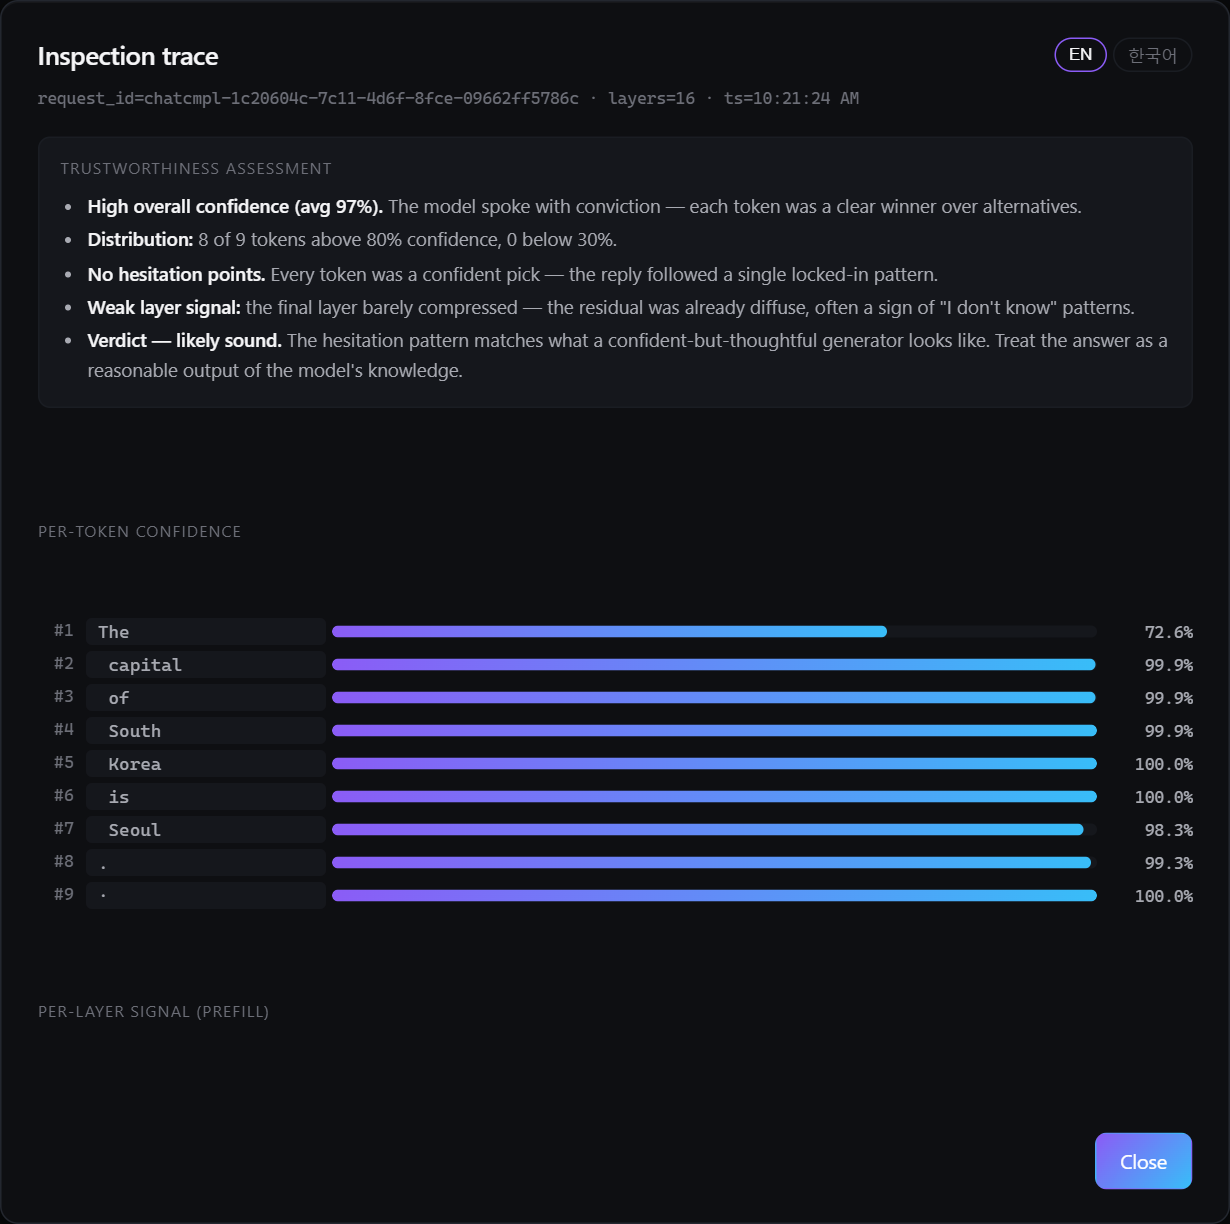 図2. 正しい回答に対する全体的に高い確信度を示すトラストパネル。ほとんどのトークンが80%以上の確信度を示す。
この正しい回答に対して、トラストパネル(図2)は全体的に高い確信度を示し、平均97%でした。9トークンのうち8トークンが80%以上の確信度で、30%未満のトークンは0トークンでした。特に「Seoul」というトークン自体の確信度は98.3%であり、その判断は「likely sound」(おそらく健全)とされていました。
次に、誤った前提の質問が提示されました。「Which Korean scientist won the 2019 Nobel Prize in Physics?」(2019年にノーベル物理学賞を受賞した韓国人科学者は誰ですか?)この質問は誤った前提に基づいています(2019年の受賞者はジェームズ・ピーブルス、ミシェル・マイヨール、ディディエ・ケローで、韓国人はいません)。モデルは「The 2019 Nobel Prize in Physics was awarded to Tsunemi Matsumoto, Masato Nakanishi, and Shun-Hee Lee, who won for their work on the development of high-temperature superconducting materials.」(2019年のノーベル物理学賞は、高温超電導材料の開発に関する業績により、松本経美、中西正人、イ・スンヒに授与されました。)と、架空の人物と研究を作り出して回答しました。
 図3. ハルシネーションされた回答のトークンごとの確信度。テンプレートを構成するトークンは確信度が高かった(例:「Nobel」99.8%、「Physics」99.4%、「awarded」88.1%)ものの、人物名を示すトークンの確信度は急落しました(例:「Ts」7.7%、「un」11.4%、「emi」29.4%、「Mas」2.3%、「N」7.8%、「akan」16.6%、「Sh」3.5%)。
ハルシネーションされた回答のトークンごとの確信度(図3)を調べると、明確なパターンが浮かび上がりました。テンプレートを構成するトークンは確信度が高かった(例:「Nobel」99.8%、「Physics」99.4%、「awarded」88.1%)ものの、人物名を示すトークンの確信度は急落しました(例:「Ts」7.7%、「un」11.4%、「emi」29.4%、「Mas」2.3%、「N」7.8%、「akan」16.6%、「Sh」3.5%)。
 図4. ハルシネーションされた回答のトラストパネル。平均59%の確信度が混在しており、50トークン中22トークンが80%以上、16トークンが30%未満でした。また、13の僅差のトークン(例:「Ts」、「un」、「emi」)も示されました。しかし、このヒューリスティックは16の低確信度トークンを決定点における「自然なためらいパターン」と解釈し、最終的な判断は依然として「likely sound」(おそらく健全)とされていました。この教訓は、パネルが出力の「どこ」を疑うべきかを示すものの、その要約判断は事実確認ではないことを示しています。RAGによる根拠付けと人間によるレビューが依然として必要です。
ハルシネーションされた回答のトラストパネル(図4)は、平均59%の確信度が混在していることを示しました。50トークンのうち22トークンが80%以上の確信度でしたが、16トークンは30%未満でした。また、13の僅差のトークン(例:「Ts」、「un」、「emi」)が特定されました。これらの指標にもかかわらず、パネルのヒューリスティックな判断は、16の低確信度トークンを決定点における「自然なためらいパターン」と解釈し、最終的な判断は依然として「likely sound」(おそらく健全)とされていました。これは重要な教訓を示しています。確信度のシグナルは出力の「どこ」を疑うべきかを示すものであり、事実確認ではありません。RAGによる明示的な引用と人間によるレビューといった根拠付けのメカニズムは依然として不可欠です。
 図5. プリフィル段階におけるレイヤーごとのシグナルを示した可視化。Llama-3.2-1B-Instructモデルの16層全体で、シグナル強度はレイヤー0で10%からレイヤー15で100%に増加し、レイヤーごとの上位アクティベーションを伴い、内部表現の段階的な形成を示しています。
zllmを用いたさらなる内部検査により、プリフィル段階におけるレイヤーごとのシグナルが明らかになりました(図5)。Llama-3.2-1B-Instructモデルの16層全体で、シグナル強度はレイヤー0で10%からレイヤー15で100%に増加し、レイヤーごとの上位アクティベーションを伴い、内部表現の段階的な形成を示しています。
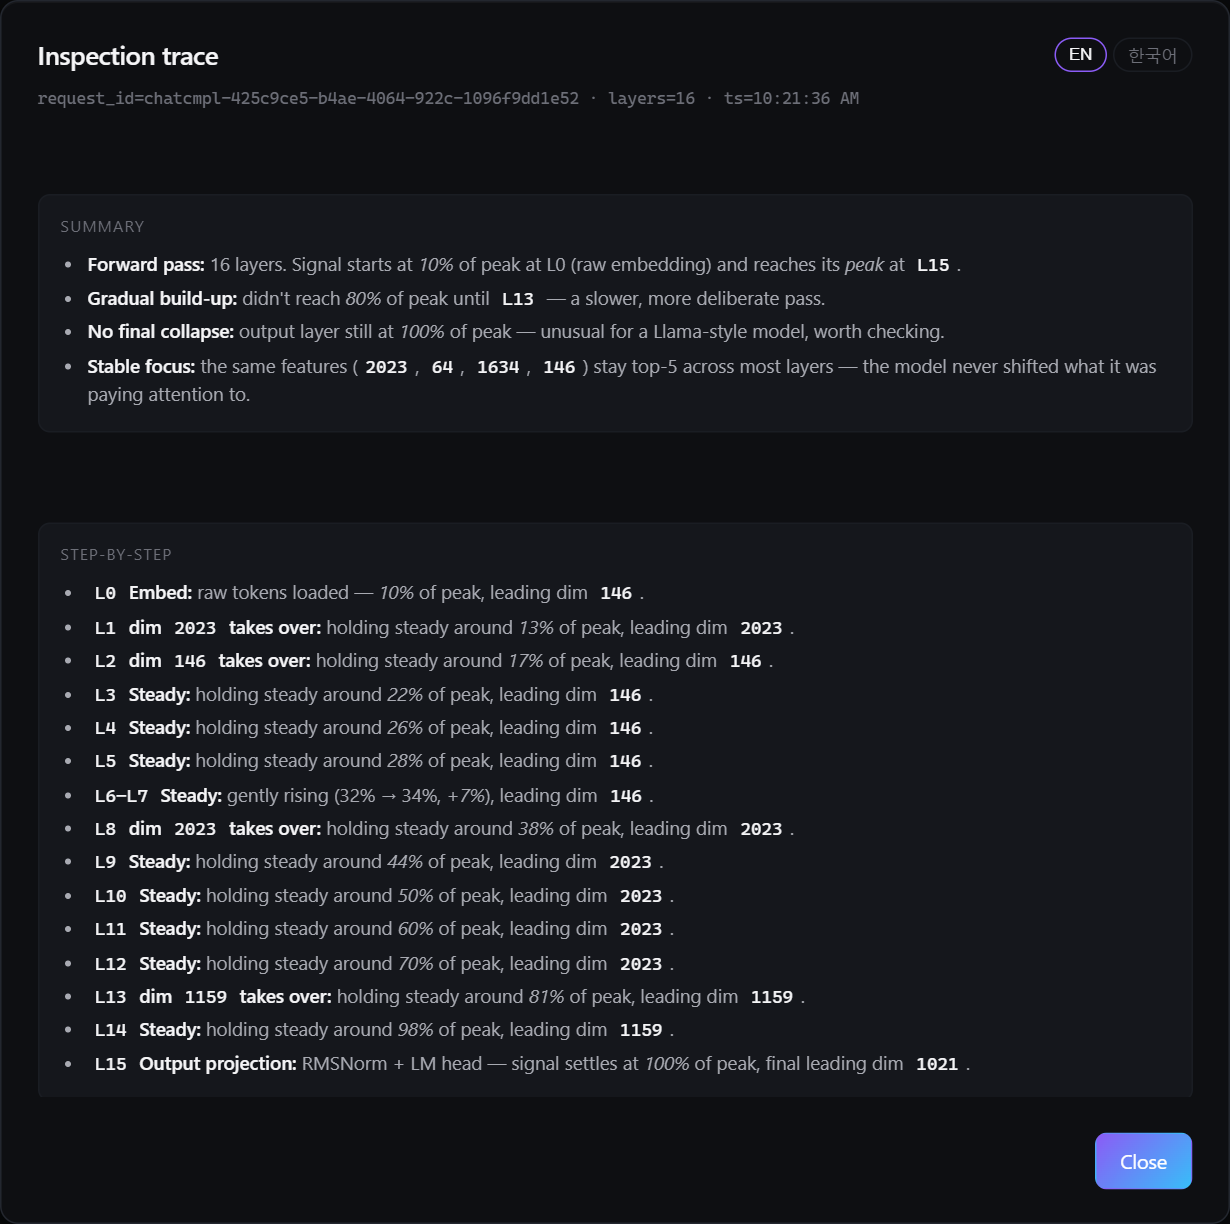 図6. モデルの内部処理の概要とステップバイステップ表示。段階的な形成(ピークの80%に達したのはレイヤー13のみ)と、最終レイヤーでの崩壊がないこと(出力レイヤーは依然としてピークの100%にあり、Llamaスタイルのモデルとしては珍しいと説明されています)、および同じ特徴量次元に安定して焦点を当てていることを示しています。
モデルの内部処理の概要とステップバイステップビュー(図6)では、出力の段階的な形成が強調され、ピークの80%に達したのはレイヤー13のみでした。このトレースは、Llamaファミリーモデルでは珍しいとされる最終レイヤーでの崩壊がないこと(出力レイヤーは依然としてピークの100%にあります)、およびレイヤー間で同じ特徴量次元に安定したアテンションが向けられていることも示していました。
コード:実際のAPIリクエストとレスポンス
既存のLLMワークフローにXAI機能を統合するには、多くの場合、標準的なAPIインタラクションが伴います。zllmはOpenAI互換のAPIを提供しており、技術的意思決定者は詳細な内省データにアクセスできます。以下は、ハルシネーション検出とログ確率を有効にするためのAPIリクエストの例とそのレスポンスの形式です。
APIリクエスト例
POST /v1/chat/completions HTTP/1.1
Host: your-zllm-endpoint.com
Content-Type: application/json
{
  "messages":[{"role":"user","content":"Which Korean scientist won the 2019 Nobel Prize in Physics?"}],
  "logprobs":true,
  "top_logprobs":2,
  "detect_hallucination":true,
  "stream":false,
  "temperature":0
}
APIレスポンス抜粋
{
  "id": "chatcmpl-xxxx",
  "object": "chat.completion",
  "created": 1700000000,
  "model": "llama-3.2-1b-instruct",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "The 2019 Nobel Prize in Physics was awarded to David J. Wineland and Gordon J. Taylor for their pioneering work on the manipulation of quantum states of atoms and molecules using laser light."
      },
      "logprobs": {
        "content": [
          // ... preceding tokens ...
          {
            "token":" Win",
            "logprob":-0.559,
            "bytes":[32, 87, 105, 110],
            "top_logprobs": [...]
          },
          {
            "token":"eland",
            "logprob":-0.056,
            "bytes":[101, 108, 97, 110, 100],
            "top_logprobs": [...]
          },
          {
            "token":" Gordon",
            "logprob":-1.67,
            "bytes":[32, 71, 111, 114, 100, 111, 110],
            "top_logprobs": [...]
          },
          {
            "token":" J",
            "logprob":-1.787,
            "bytes":[32, 74],
            "top_logprobs": [...]
          },
          {
            "token":" Taylor",
            "logprob":-2.994,
            "bytes":[32, 84, 97, 121, 108, 111, 114],
            "top_logprobs": [...]
          }
          // ... succeeding tokens ...
        ]
      }
    }
  ],
  "hallucination": {
    "risk_score":0.340,
    "mean_entropy":1.572,
    "normalized_entropy":0.134,
    "risky_fraction":0.350,
    "n_tokens":40,
    "peak_token_index":20,
    "flagged":false
  },
  "usage": {"prompt_tokens": 10, "completion_tokens": 22, "total_tokens": 32}
}
トップレベルの「hallucination」集計フラグはfalseのままで、リスクスコアも控えめでしたが、peak_token_index 20は「 Taylor」を指しています。教訓:集計フラグはfalseのままでしたが、スパンチェックは架空の名前を捉えています。また、誤った文脈にある実在の名前(デビッド・J・ワインランドは2012年にノーベル物理学賞を受賞)は高い確信度を持つ可能性があり、これがRAGによる情報源検証が必要となる理由です。
他のOpenAI互換サーバーの場合、zllm-probe(https://github.com/fankh/zllm-probe)がプロキシとして機能し、これらのXAI機能を任意の上流サービスに追加できます。
RAGによる根拠付けと確信度シグナルの組み合わせ
堅牢で信頼性の高いLLMシステムを構築するには、RAGによる外部からの根拠付けと内部の確信度シグナルを組み合わせることが重要です。このハイブリッドアプローチにより、信頼できない可能性のある出力をさらなる精査のためにルーティングする動的なポリシーが可能になります。
このプロセスには以下が含まれます。
- 回答の生成:LLMが応答を生成し、構成されている場合はRAGによって補強されます。
- 低確信度スパンの特定:同時に、ホワイトボックス推論エンジンからのトークンのログ確率とハルシネーションリスクスコアが、モデルの確信度が低い特定の単語やフレーズを強調します。
- 取得された情報源との相互参照:これらの低確信度スパンは、RAGシステムから取得された元の情報源と自動的に照合され、情報が裏付けられているか、またはモデルが内容を捏造しているかどうかが検証されます。
- 人間によるレビューへのルーティング:確信度シグナルが事前定義された閾値を下回る場合、またはハルシネーションリスクスコアが高い場合、出力はHuman-in-the-Loop(HITL)レビュー担当者にルーティングされ、検証されます。
例えば、以下のようなポリシーが考えられます。
{
  "policy_name": "LLM Output Vetting Policy",
  "trigger_conditions": [
    {"type": "hallucination.flagged", "value": true},
    {"type": "hallucination.risk_score", "threshold": "AGREED_THRESHOLD", "operator": ">"},
    {"type": "logprob.risky_fraction", "threshold": "AGREED_THRESHOLD", "operator": ">"}
  ],
  "action": "ROUTE_TO_HUMAN_REVIEW"
}
これにより、組織はモデルのパフォーマンスのベースラインを測定した後に合意された閾値を設定し、信頼性の検証可能なリスクがある応答のみをエスカレートして、人間の監視リソースを最適化しつつ、高水準の正確性を維持することができます。さらに、名前、数字、または日付内に連続する低確率トークンが検出された場合、回答をレビューまたは情報源検証にルーティングするというスパンレベルのルールも追加されます。
規制とガバナンス
LLMが重要なビジネスオペレーションに不可欠になるにつれて、AIに関する規制環境は急速に進化しており、透明性と説明可能性が強調されています。技術的意思決定者は、LLMの展開がこれらの新たな要件をどのように満たすかを考慮する必要があります。説明義務の証拠を提供するためには、堅牢なロギングと監査証跡が不可欠です。
このニーズを推進する主要な規制フレームワークには以下が含まれます。
- NIST AI Risk Management Framework (AI RMF 1.0):このフレームワークは、AIライフサイクル全体における透明性、説明可能性、および説明責任を強調し、組織に不透明なAIシステムに関連するリスクを管理することを求めています。
- EU AI Act:第13条は高リスクAIシステムに対する透明性要件を義務付けており、第86条は高リスクAIの決定によって影響を受ける個人に対して「説明を受ける権利」を規定しています。これにより、LLMが特定の出力にどのように、なぜ到達したかに関する詳細な記録が必要になります。
- 韓国のAI基本法(인공지능 발전과 신뢰 기반 조성 등에 관한 기본법):2026年1月22日から施行されているこの法律は、高影響AIシステムに関する透明性と説明義務の要件を概説しており、組織に説明可能な実践を採用するよう促しています。
このような規制に準拠するため、組織は以下をログに記録する必要があります。
- 入力プロンプトとコンテキスト:正確なクエリとRAGによって取得された文書。
- 出力応答:生成されたテキスト全体。
- XAIシグナル:トークンのログ確率、エントロピー、ハルシネーションリスクスコア、およびフラグ。
- 内部トレース:診断目的のためのレイヤーごとのアクティベーションデータまたはアテンションウェイト。
- 人間によるレビュー結果:HITLレビュー担当者によって下された決定、正当化、および修正。
- モデルメタデータ:モデルバージョン、量子化の詳細、使用された推論エンジン(例:zllm)。
これらのログは監査可能な証跡として機能し、LLMリスクの管理におけるデューデリジェンスと透明性要件の履行を示します。
限界と正直な注意点
XAI技術はLLMの透明性を大幅に向上させますが、技術的意思決定者にとって、その固有の限界を理解することが重要です。
- 確信度は真実ではない:デモンストレーションで示されたように、LLMは一見もっともらしい確信度スコアでハルシネーションされた回答を生成できます。トークンのログ確率における高い確信度は、モデルの内部的な確信度を示すものであり、必ずしもコンテンツの事実の正確性や真実性を示すものではありません。外部からの根拠付け(RAG)と人間による検証は依然として不可欠です。
- レイヤーごとのトレースは診断的であり、完全な説明ではない:レイヤーごとのトレースはLLMの内部メカニズムに関する非常に貴重な洞察を提供しますが、アクティベーションパターンとアテンションフローの低レベルで数値的な視点を提供します。これらの複雑な診断を、モデルが特定の高レベルの決定を「なぜ」行ったのかに関する人間が理解できる因果関係のある説明に変換することは、依然として複雑な課題です。これらは強力なデバッグツールですが、直感的な人間の推論と直接的に同義ではありません。
- 意図的に小さなモデルを使用:本稿のデモンストレーションでは、ハルシネーションを容易に再現し強調するために、意図的に小さなモデル(Llama-3.2-1B-Instruct)を使用しました。より大規模で高性能なLLMは異なる確信度パターンを示し、より明白なハルシネーションが少ない可能性がありますが、内部構造を検査するための根底にあるXAIの原則は依然として関連性があります。
主なポイント
- 静的な特徴量重要度のために設計された従来のXAI技術は、LLMの動的でシーケンシャルな性質には不十分です。
- LLMには、外部のエビデンス(RAG)、内部の確信度シグナル(ログ確率)、メカニズムのトレース(ホワイトボックス推論)、構造化された根拠、人間による監視を組み合わせた多層的なXAIアプローチが不可欠です。
- zllmのようなホワイトボックス推論エンジンは、LLMの動作に関する詳細な洞察を提供し、正しい応答とハルシネーションされた応答の詳細な分析を可能にします。
- トークンの確信度シグナルは、LLMの出力が「どこで」信頼できない可能性があるかを示しますが、「なぜ」信頼できないのか、または事実が誤っているのかは示しません。RAGと人間によるレビューは、事実確認にとって依然として重要です。
- NIST AI RMF、EU AI Act、韓国のAI基本法などの規制フレームワークは、AIシステム、特に高リスクと見なされるシステムに対して、透明性、説明可能性、および説明責任をますます義務付けており、LLM展開には堅牢なロギングと監査機能が不可欠です。
- 進歩にもかかわらず、LLM向けのXAIには限界があります。確信度は真実を意味するものではなく、内部トレースは診断ツールであり、人間のような直接的な説明ではありません。
FAQ
LLM向けExplainable AI(XAI)とは何ですか?
LLM向けXAIとは、大規模言語モデルの出力と内部動作を技術的意思決定者が理解できるようにする方法とツールを指します。LLMの「ブラックボックス」的な性質を解明し、特定の応答がなぜ生成されたのかについての洞察を可能にし、ハルシネーションの検出を促進し、コンプライアンスを確保することを目的としています。
従来のXAI技術がLLMに適さないのはなぜですか?
SHAPやLIMEのような従来のXAI技術は、主に静的な表形式データセットにおける特徴量の重要性に焦点を当てています。しかし、LLMは動的でシーケンシャルな生成モデルであり、文脈に基づいて情報を処理および生成するため、その複雑な高次元の内部状態に対して静的な特徴量帰属は困難であり、ほとんど情報を提供しません。
zllmのようなホワイトボックス推論エンジンは、LLMの説明可能性にどのように役立ちますか?
zllmはホワイトボックス推論エンジンとして、各処理レイヤーおよびトークン生成ステップにおけるLLMの内部状態を公開します。これにより、トークンごとの確信度分析、疑わしいためらいパターンの検出、および内部アクティベーションパスウェイの追跡が可能になり、モデルの意思決定プロセスに関する前例のない診断詳細が提供されます。
確信度スコアだけでハルシネーションを検出できますか?
確信度スコア(例:トークンのログ確率)は、LLMの出力のうちモデルが内部的に確信度が低い部分を強調することができ、ハルシネーションが発生しやすい領域を示します。しかし、高い確信度が事実の正確性を保証するものではありません。したがって、確信度シグナルは、信頼性の高いハルシネーション検出と事実確認のために、外部からの根拠付け(RAG)と人間によるレビューと組み合わせる必要があります。
規制はLLMの説明可能性においてどのような役割を果たしますか?
EU AI Act、NIST AI RMF、韓国のAI基本法などの規制フレームワークは、AIシステム、特に高リスクと見なされるシステムに対して、透明性、説明可能性、および説明責任をますます義務付けています。これらの規制により、組織はLLMの動作に関する監査可能な証拠と説明を提供するためにXAIプラクティスを実装し、倫理的な展開とユーザーの信頼を確保する必要があります。
参考文献
- zllm GitHub
- zllm-probe GitHub
- DARPA XAIプログラム
- SHAP
- LIME
- NIST AI RMF 1.0
- EU AI Act (Regulation (EU) 2024/1689)
- 인공지능 발전과 신뢰 기반 조성 등에 관한 기본법 (AI開発と信頼基盤の造成等に関する基本法)